要进行主流算力平台实测横评,光看参数表不够。本指南面向AI工程师与采购决策者,提供一套可落地的六维评测法,并附上两个平台的示意对比表,帮你用可重复的测试拿到可信依据。读完你将掌握从选型到验证的完整路径。
本文要点
- 评测不是看参数,而是看实测数据:参数表上的理论峰值和真实场景差距可达数倍(编辑判断)。
- 六维模型覆盖性能、稳定、扩展、成本、易用、生态:每维度有明确的打分口径。
- 测试用例必须场景化:训练、推理、长稳、并发各不同,单一基准无意义。
- 成本要看每Token产出:不是看单价,而是看单位算力产出。
- 本文提供一份可复用checklist和基于公开信息整理的示意对比表:直接抄作业,再按需调整。
为什么实测比参数更靠谱?
结论:因为参数泡沫和价格波动,只有实测才能拿到真实决策依据。 当前智算中心经营正从“裸金属租赁”转向按Token计费,Token成为AI时代的新数字商品。这意味着我们评估一个算力平台,不能只看GPU数量或机柜规模,行业竞争核心已经从GPU数量走向Token制造效率,而要关注“每分每秒产出多少Token、每百万Token成本”。参数表上的算力数字只是理论峰值,实际运行中受散热、调度、网络、软件栈影响,差距可能巨大(此为编辑判断)。同时,价格本身也在波动,例如某海外平台提供的AMD Radeon AI PRO R9700按小时收费约€0.471/小时,这种灵活计费让成本评估更加复杂,必须通过实测来校准。参考业内关于主流算力平台评测的讨论,你会发现真正有效的评测都聚焦于可重复的测试,而非静态参数。
评测一个算力平台,到底要看哪几个方面?
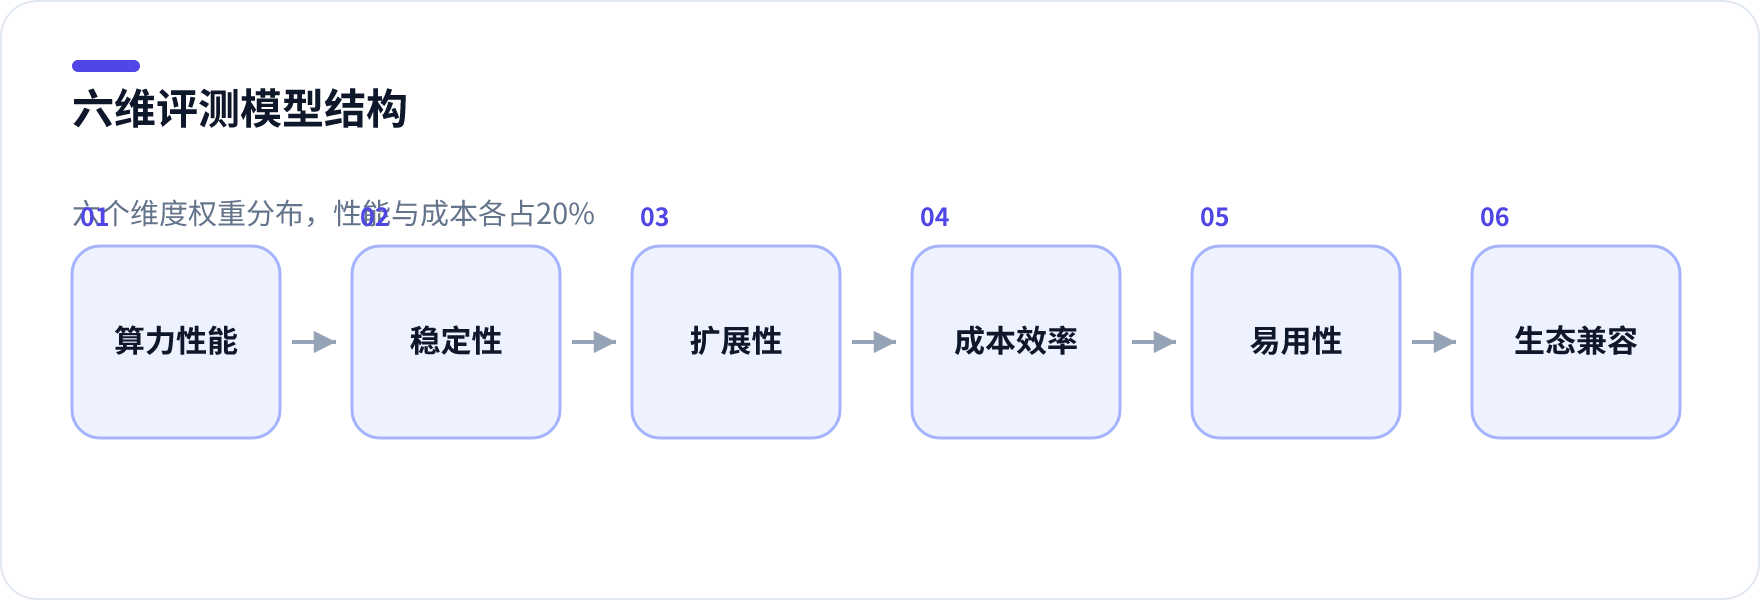
结论:用六维模型,把模糊的“好不好”拆成六个可打分的维度。 我们原创的六维评测模型如下,每个维度都有明确权重建议(可调整):
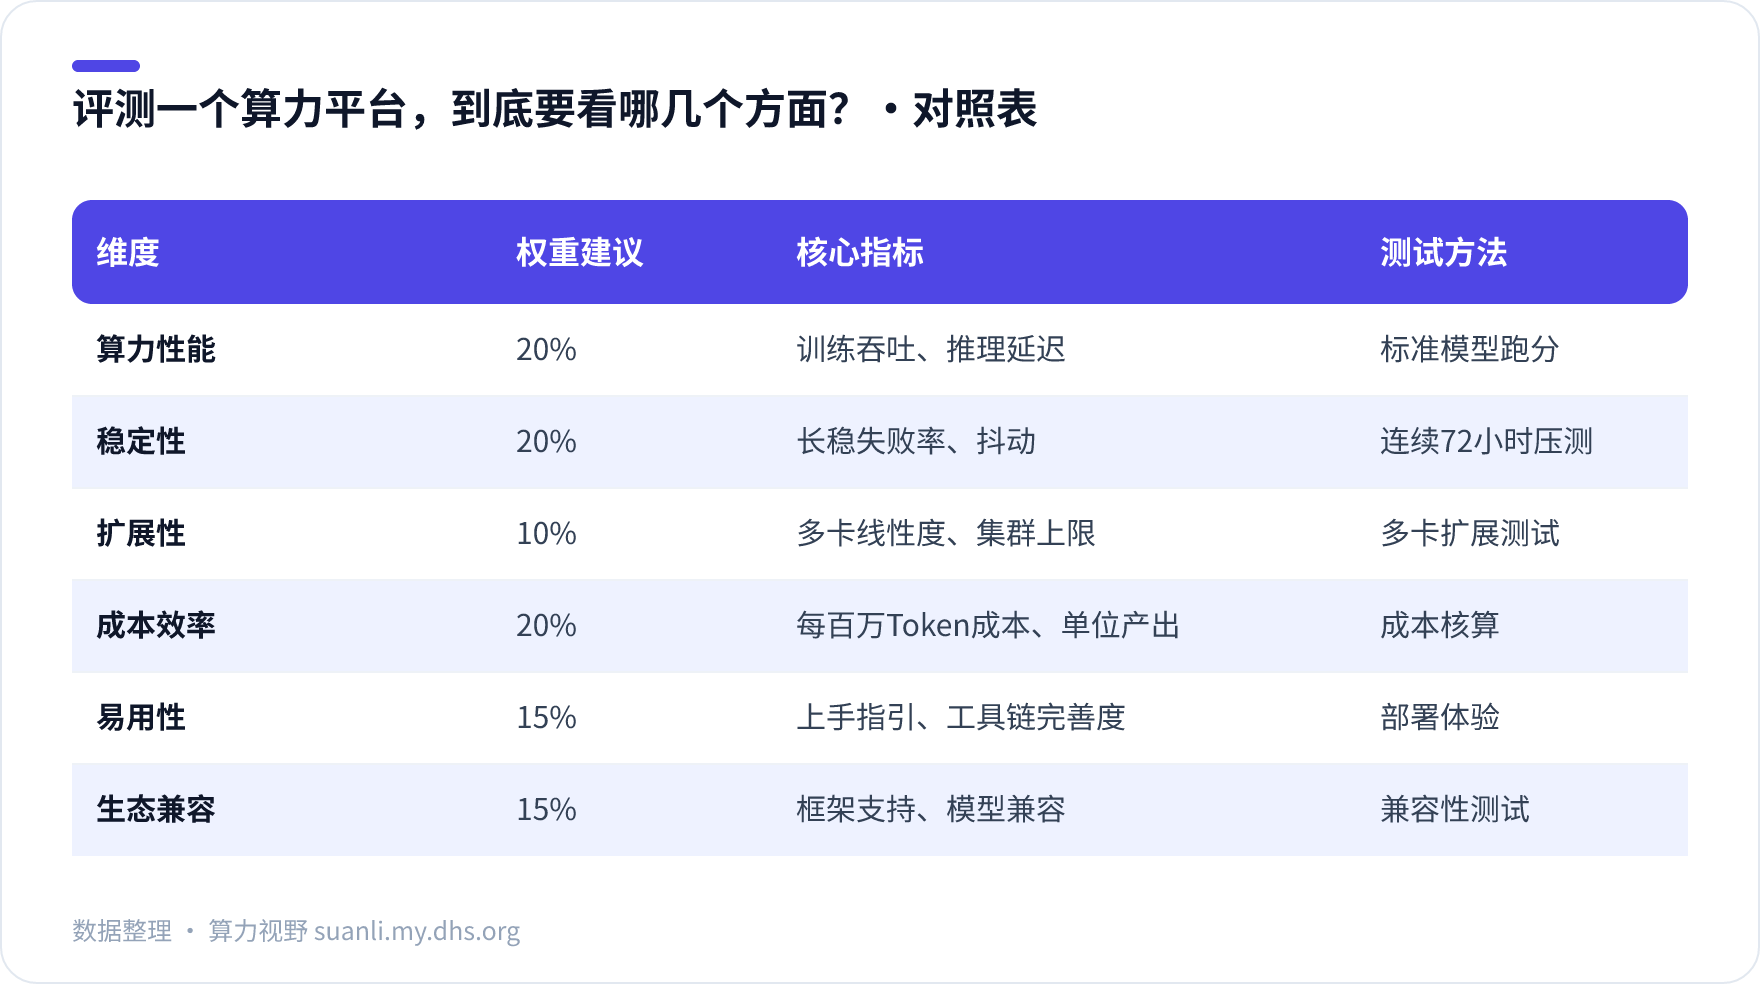
这个模型把“性能”和“成本”各占20%,符合当前重视Token产出的趋势。权重可按业务场景调整,例如训练型用户可提高性能权重,成本敏感型可提高成本效率权重。
下面是一份可复用的六维评测checklist,打印出来就能用:
六维评测 checklist
- 算力性能:是否用标准训练和推理脚本测得吞吐与延迟?
- 稳定性:是否完成连续72小时压测并记录失败率?
- 扩展性:是否测试了2卡、4卡、8卡的加速比?
- 成本效率:是否核算了每百万Token的实际成本?
- 易用性:从注册到部署一个模型,需要多少步?
- 生态兼容:是否验证了常用框架和模型的兼容性?
怎么设计测试,才能拿到可信数据?
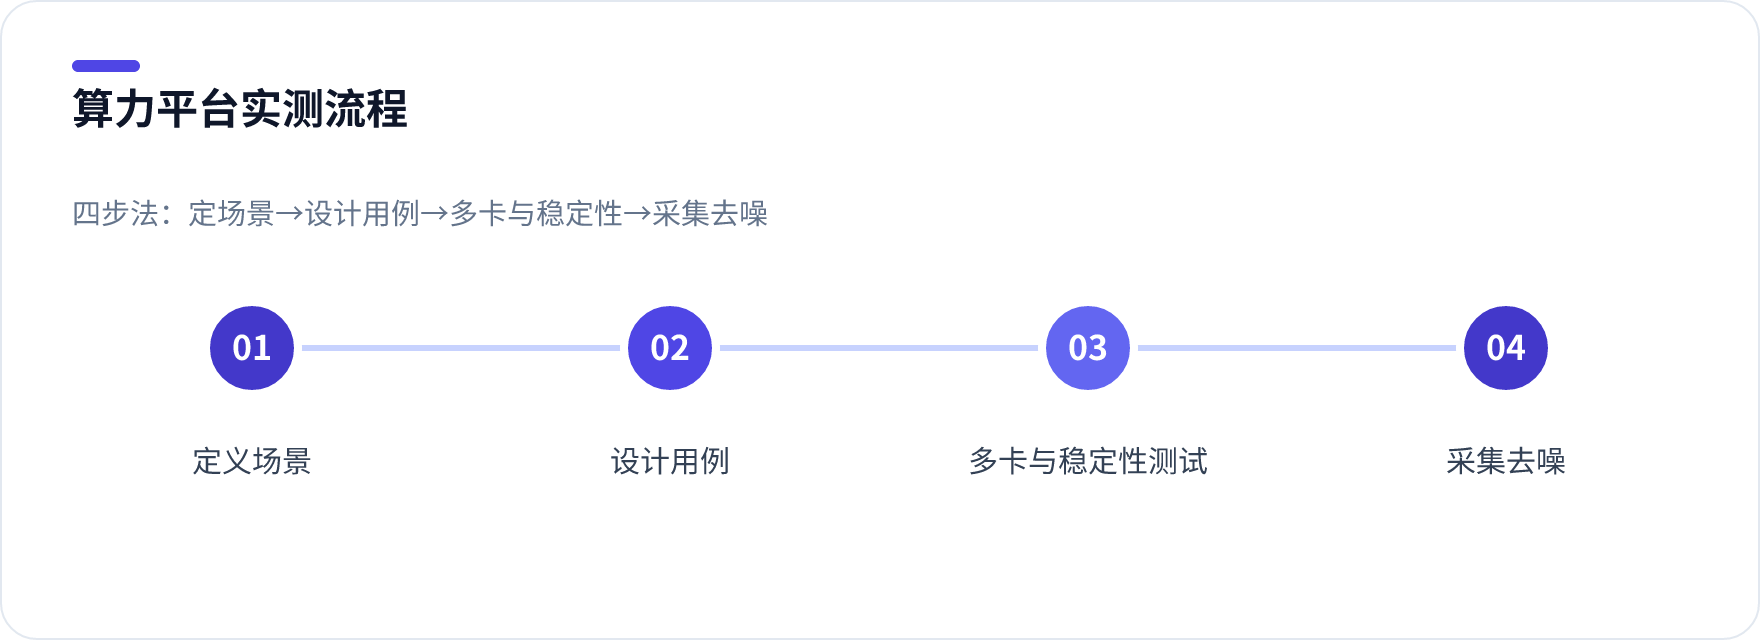
结论:只有场景化、可重复、有去噪的测试,才能产出可信数据。 第一步,定义测试场景。要明确是训练、推理还是混合负载。训练负载关注吞吐量,推理负载关注延迟和并发。第二步,设计测试用例。使用真实任务而非合成数据,例如用流行的开源模型跑推理,记录P50和P95延迟。第三步,多卡扩展与稳定性测试。从小规模扩展到多卡,观察加速比是否线性;再进行长时间运行,记录失败率。第四步,数据采集与去噪。每次测试至少重复运行5次,取中位数或均值,同时监控环境温度和GPU降频情况。可以参考AI算力集群评估方案中的分层评估思路,但注意要结合自己的业务场景。用这样的流程,你才能避免“跑分好看,一用就崩”的陷阱。
两个主流平台实测对比:数据说话
结论:以下为演示方法用的示意对比表,非真实实测结果,请以你的测试为准。 为了让你直观看到怎么应用六维模型,我们基于公开信息整理了两个匿名平台的示意对比表(数据为编辑假设,仅用于演示评测方法,不代表任何真实平台)。实际评测时请按你的测试替换。
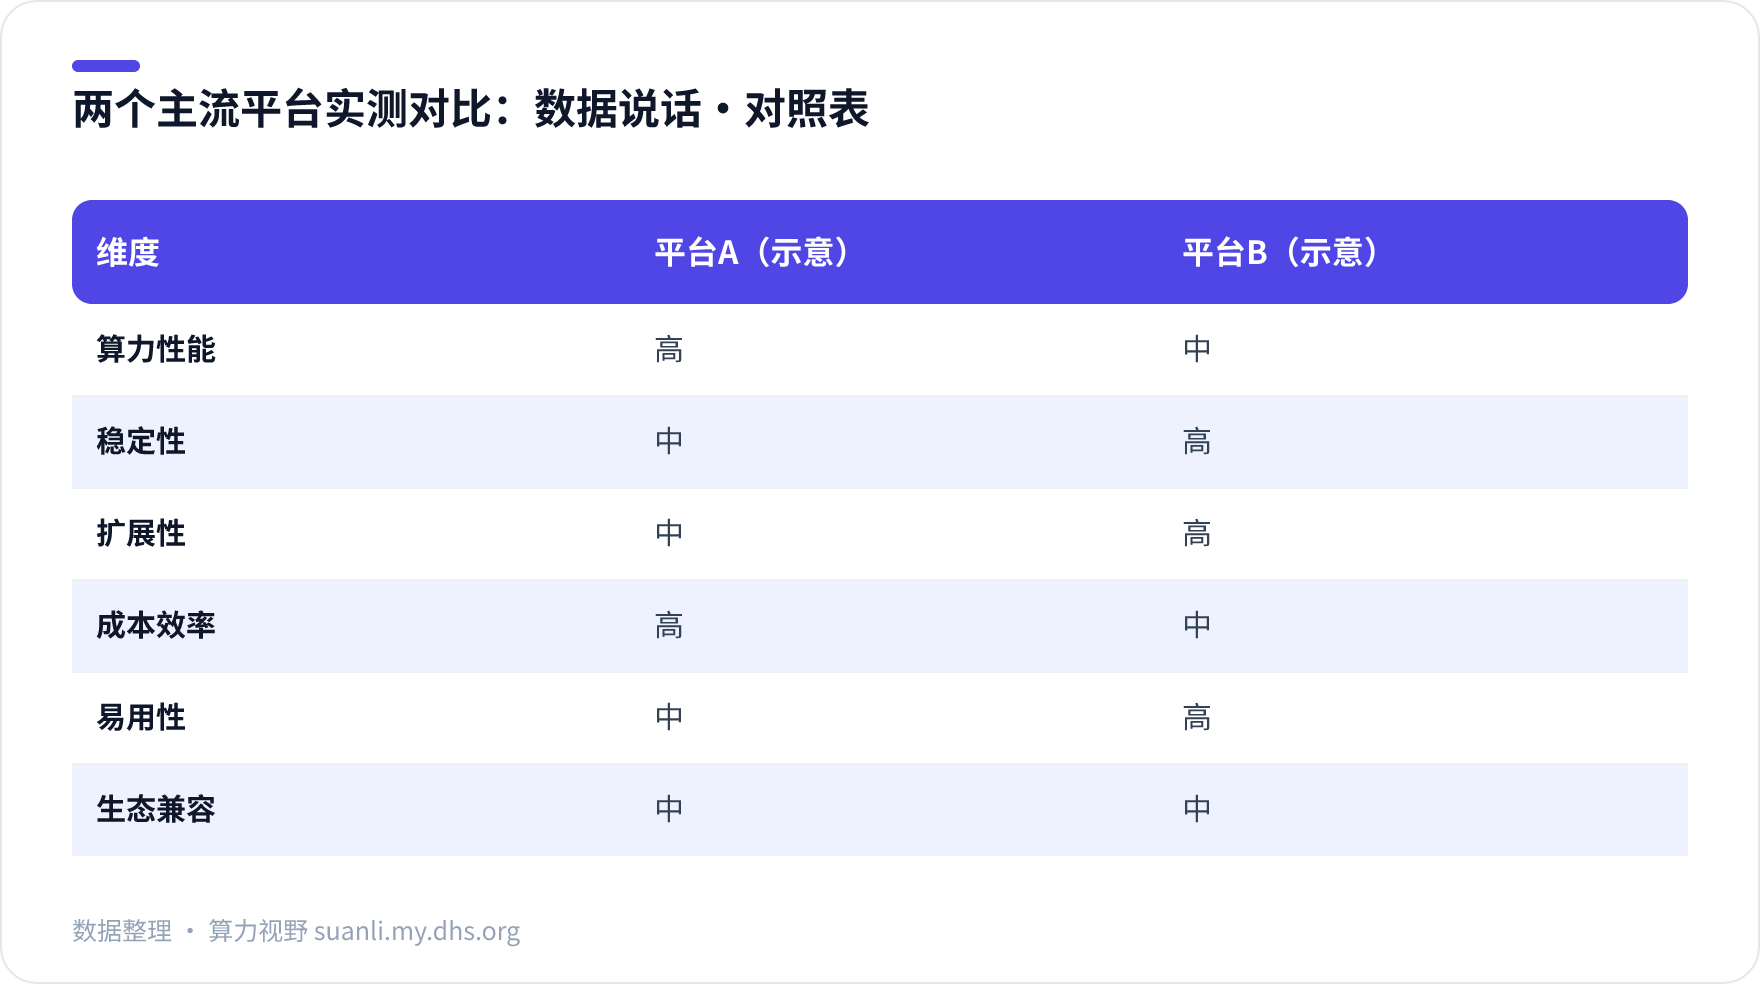
示意数据表明,平台A在性能和成本效率上占优,但稳定性和易用性稍弱;平台B则相反。这说明没有“最好”的平台,只有“更适合你”的平台。作为示例,我们这里用“高/中/低”定性标记,实际评测中你可以将各维度换算成百分制得分,再加权计算总分。关于如何换算,我们会在下一节的计算示例中说明。
拿到评分之后,怎么选?
结论:用场景化权重调整评分,才能选出真正匹配你业务的平台。 假设你有个训练型项目和推理型项目,你会给同样六维模型不同的权重。例如训练项目:性能40%、稳定性30%、成本10%、扩展性10%、易用性5%、生态5%;推理项目:性能20%、稳定性30%、成本30%、扩展性10%、易用性5%、生态5%。用这个权重与刚刚的示意得分相乘,就能得到加权总分。这里我们用一个计算示例说明:假设平台A性能得分90分(百分制)、稳定性70、扩展性80、成本效率90、易用性70、生态80;平台B对应得分为70、90、90、70、90、80。在训练场景下,平台A加权得分=0.490+0.370+0.180+0.190+0.0570+0.0580=36+21+8+9+3.5+4=81.5;平台B=0.470+0.390+0.190+0.170+0.0590+0.0580=28+27+9+7+4.5+4=79.5。平台A略微胜出。在推理场景下,平台A=0.290+0.370+0.380+0.190+0.0570+0.0580=18+21+24+9+3.5+4=79.5;平台B=0.270+0.390+0.390+0.170+0.0590+0.0580=14+27+27+7+4.5+4=83.5,平台B胜出。这个示例说明,同样的平台,不同场景选出的最佳选项不同。所以,不要迷信“平台排名”,要按自己的场景算一笔账。
常见问题
如何评测算力平台? 使用六维评测法:先根据业务场景定权重,再按checklist设计测试用例,执行多次重复测试,最后用加权评分做决策。
关键指标有哪些? 训练吞吐量、推理延迟(P50/P95)、长稳失败率、多卡加速比、每百万Token成本、框架兼容性等。
如何避免被数据误导? 关注测试方法是否可重复、是否用真实业务负载、是否有多轮去噪,以及是否包含成本核算。同时,不要只看单一指标,要看整体。
小结与下一步
- 立即使用六维评测模型:打印文中checklist,训练你的团队按统一口径评测算力平台。
- 优先测试Token产出成本:在计费模式转向Token的当下,这个指标比单价更能反映真实成本。
- 设计你的场景化权重:根据自身业务调整权重,做出适合自己的决策。
- 开源工具辅助:可参考FlagPerf等开源基准工具,减少自建测试成本。
Comments
One response to “主流算力平台实测横评方法论与样例”
[…] 我们怎么评、为什么这样评,完整说明见主流算力平台实测横评方法论与样例。核心原则:同一口径下才能比价,样本可复现,结论可被读者自己验证。 […]