这篇观察面向算力采购与技术决策者。你将了解国产算力生态当前所处阶段、昇腾与寒武纪与国产大模型的适配进展,以及如何评估生态成熟度来支撑选型。本文基于公开信息与行业观察,提供一份原创适配矩阵,供决策参考。
本文要点
- 国产算力生态已进入“生态成势”阶段,昇腾与寒武纪为头部双强(编辑判断)。
- 国产大模型适配加速,DeepSeek等开始全面拥抱国产算力。
- 软硬件协同仍是关键缺口,性能损耗需谨慎评估。
- 采购决策可聚焦开发者数量、工具链兼容性与性能优化。
- 智算中心商业模式正从GPU数量转向Token产出效率。
国产算力生态全景:芯片、服务器与软件栈三层结构
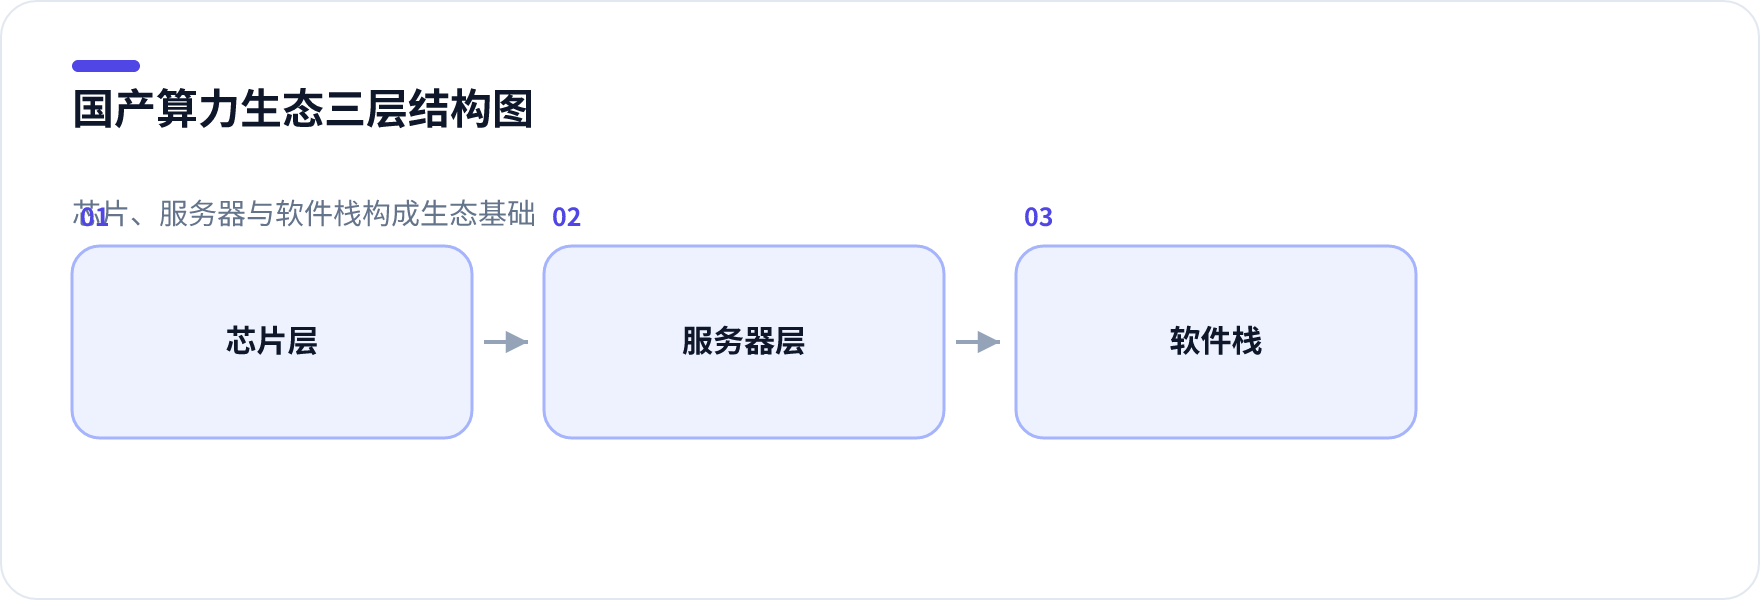
结论:国产算力生态已形成“芯片+服务器+软件栈”的三层结构,而非单点硬件突破。
在芯片层,华为昇腾、寒武纪、海光等成为国产算力的主要供给者。据中国计算机学会(CCF)2024年报告,国产算力正从“单点突破”迈向“生态成势”。CCF报告
服务器层,整机厂商围绕昇腾、寒武纪推出系列AI服务器,兼容性成为竞争焦点。以算家云为代表的算力平台在“国产专区”中强调“信创合规、本地适配、生态兼容”,反映出生态兼容已成为采购的重要考量。
软件栈是生态的基石,包括深度学习框架、加速库和算子。据科技日报报道,智算中心传统“裸金属租赁”模式正转向按Token计费,“Token成为AI时代的新数字商品”。科技日报报道 这种转变要求软件栈能高效生产Token,而不仅是跑通模型。
国产模型适配进展:DeepSeek为何选择国产算力?
结论:DeepSeek等头部模型正加速拥抱国产算力,标志着国产算力从“可用”迈向“好用”。
多份公开报道显示,DeepSeek V4带来八大变局,其中就包括对国产算力的深度适配。武汉市数据局报道 为什么DeepSeek选择国产算力?核心驱动力包括成本、自主可控和生态兼容。国产算力在推理场景中性价比优势明显,且可规避地缘政治风险。
从适配矩阵看,昇腾与寒武纪的适配走在行业前列。下表基于公开信息与行业观察,适配状态为编辑判断,非实测数据,采购决策请以厂商官方公告与实测为准。
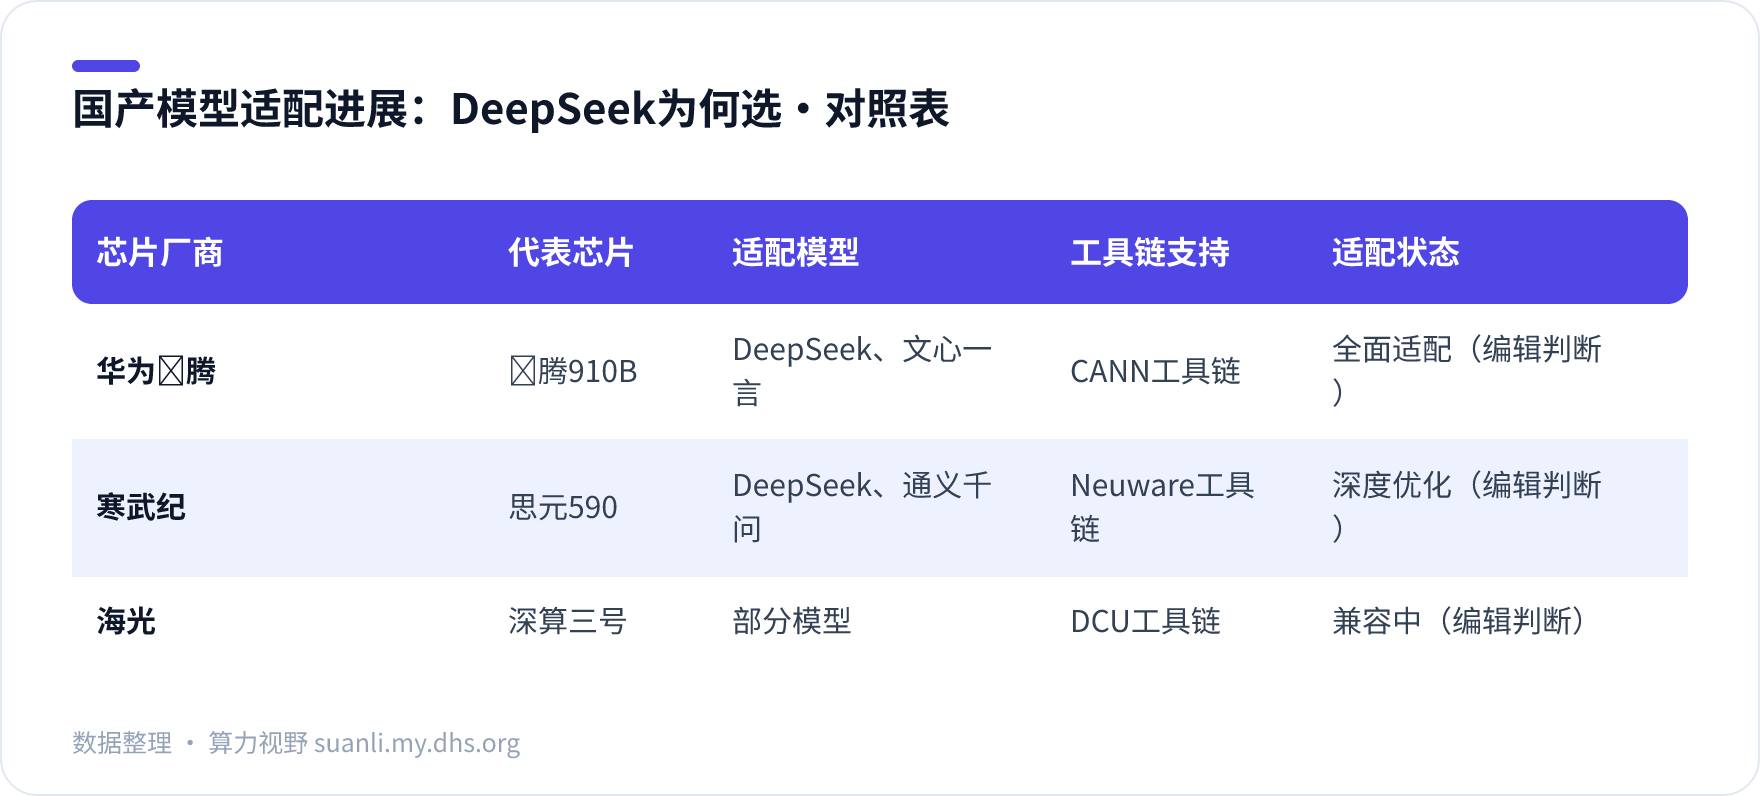
注:上表基于公开信息整理,性能表现未实测,具体以官方公告为准。
在AIGC工具导航中,算力平台已成为独立的导航分类,这印证了算力平台正成为模型落地的关键基础设施。
生态成熟度关键指标:开发者数量、工具链兼容性与性能优化
结论:评估国产算力生态成熟度,开发者数量、工具链兼容性和性能优化是三个核心维度。
开发者数量直接决定生态活力。一个仅有硬件、缺乏开发者的生态会迅速萎缩。昇腾社区和寒武纪开发者社区是观察活跃度的窗口。目前,国产AI芯片的开发者数量较英伟达仍有数量级差距,但快速增长。
工具链兼容性影响迁移成本。目前CANN、Neuware、DCU在算子覆盖度和易用性上仍与CUDA有差距。选择工具链完善、文档齐全的厂商可降低迁移成本。
性能优化是最终判断标准。智算中心的经营指标已从GPU数量转向Token产出效率与每百万Token成本。科技日报报道 即便单卡性能低于英伟达,但通过深度优化,国产厂商的Token产出效率可接近国际水平。
竞争格局:华为昇腾、寒武纪、海光与英伟达的优劣对比
结论:昇腾和寒武纪在国产替代中占先,但英伟达在生态成熟度上仍领先(编辑判断)。
华为昇腾的CANN工具链在国产阵营中最为完善,但闭源策略可能限制部分开发者。寒武纪在训练和推理领域均有布局,但生态仍在扩张期。海光基于x86与DCU路线,兼容性较好,但模型适配数量较少。英伟达的CUDA生态是壁垒,国产算力短期内无法完全替代。21世纪经济报道WAIC观察
下表为定性对比,供决策参考。
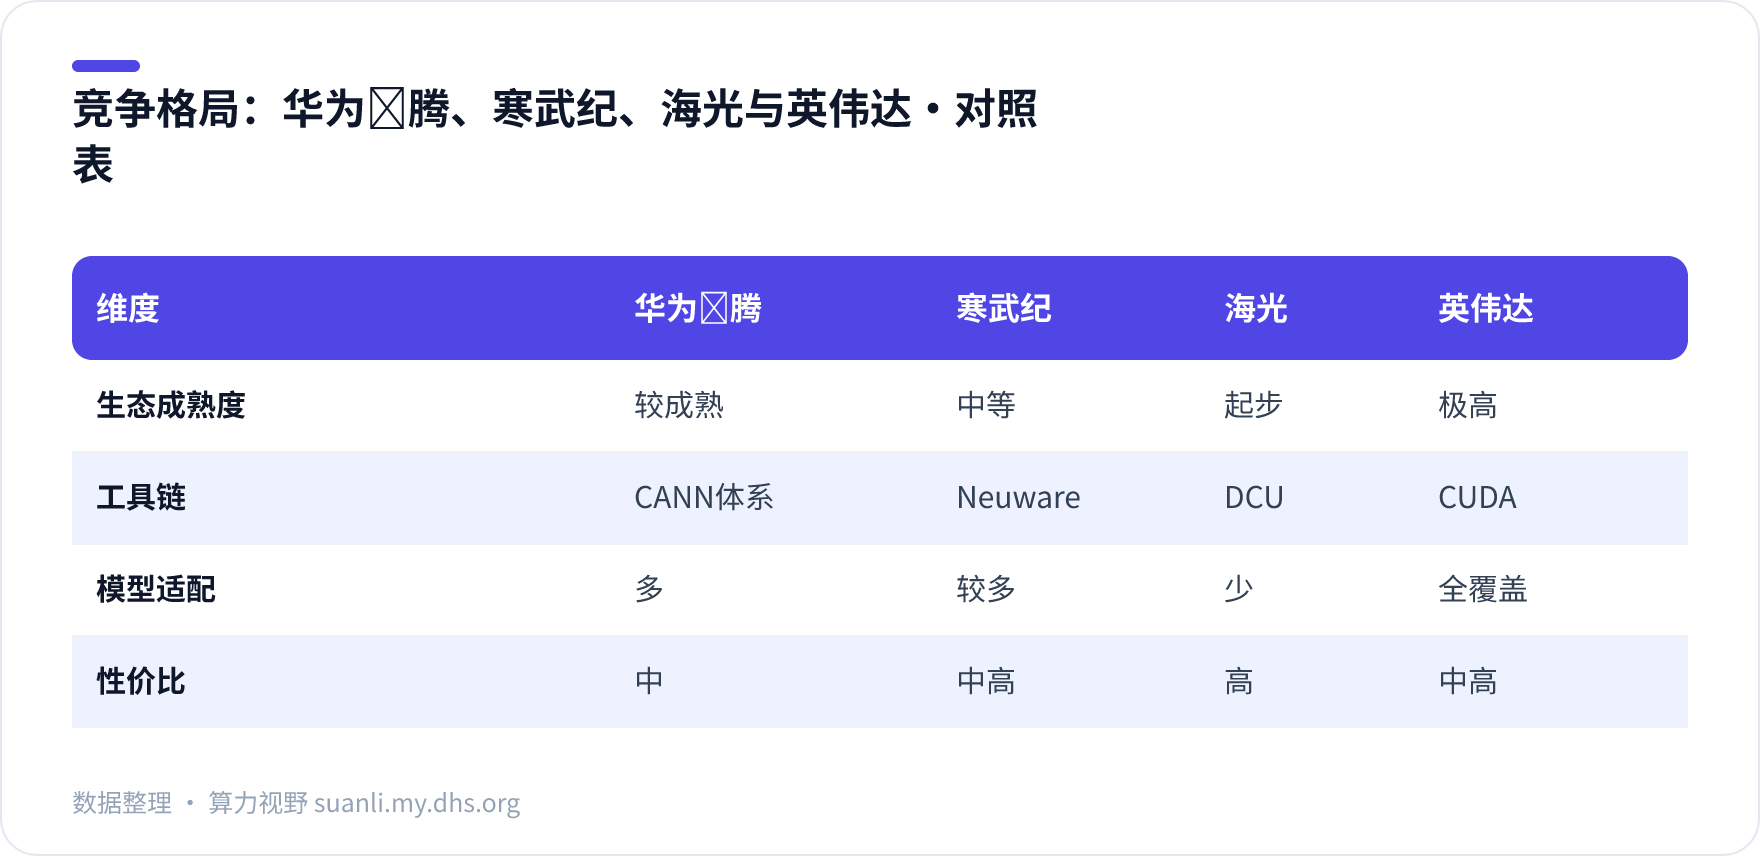
注:以上为定性判断(编辑判断),具体参数以官方为准。
挑战与破局:从“能用”到“好用”的三大缺口
结论:国产算力生态仍面临工具链不完善、开发者规模不足和行业适配深度不够三大缺口。
工具链不完善是首要问题。许多国产芯片缺少高频算子支持,导致模型迁移时需手写算子,开发周期大幅延长。例如,某些模型训练框架在国产芯片上需要额外适配,增加工程投入。
开发者规模不足使生态积累慢。虽然算家云等平台提供200+模型一键启动服务(算家云模型服务),但模型覆盖仍有限,且对开发者生态的带动作用尚未完全释放。
行业适配深度不够。金融、医疗等关键行业合规性要求高,国产算力需要更深的行业打磨。破局之道在于开源、开放和生态共建,让更多开发者参与进来,才能从“能用”走向“好用”。
常见问题FAQ
Q:国产算力适配会影响模型性能吗?
A:有一定影响。由于工具链和算子库的差异,模型在国产芯片上的性能通常低于英伟达,但通过优化可以缩小差距。建议在实际场景中做基准测试。
Q:采购国产算力需要注意什么?
A:重点关注工具链兼容性、生态成熟度和后续支持。不要只看单卡价格和算力峰值,要看Token产出效率和每百万Token成本。
Q:DeepSeek等模型为什么选择国产算力?
A:出于成本自主可控和生态兼容考虑。国产算力在推理场景中性价比优势明显,同时可以规避地缘政治风险。
Q:国产算力生态多久能够成熟?
A:没有固定时间表,但开发者数量是先行指标。如果开发者数量持续增长,生态成熟可能3-5年内到来。
小结与下一步
- 先做小规模试点,选取1-2个模型在国产算力上跑通。
- 建立基准测试,比较Token产出效率和成本。
- 优先选择工具链完善、生态活跃的芯片厂商。
- 关注行业案例,看友商在类似场景的适配经验。
- 持续跟踪头部模型的适配公告,更新评估。
Comments
One response to “国产算力生态观察(昇腾/寒武纪与国产模型适配)”
[…] 国产算力现在能跑大模型吗? 昇腾/寒武纪/海光都能承载主流开源模型的推理与中等规模训练,生态工具链在快速补齐;选型看迁移成本(CUDA 资产折价)与行业合规要求,参考国产算力生态观察。 […]