每有大模型发布,算力江湖总会重新洗牌。本文面向AI架构师、算力采购决策者与云厂商,用一篇深度长文拆解模型迭代如何改变算力需求结构:训练算力与推理算力的此消彼长、效率提升带来的需求反增、国产芯片适配的Day 0机会,以及租赁市场如何选型。读完你将拿到一张原创对照表和一个演化阶段checklist,用于调整算力预算与采购节奏。
本文要点
- 大模型发布后,算力需求结构正从训练主导转向推理主导,推理侧调用量成为主要增量。
- 模型效率提升与算力需求增长并不矛盾,反而可能触发“非线性”需求反弹。
- 国产算力适配已进入“Day 0”阶段,但仍在生态完善关键期。
- 算力租赁价格与需求联动增强,按Token计费成为智算中心新商业模式。
- 算力需求仍将增长,但结构分化,选型需结合预算与业务弹性。
一、大模型发布如何重塑算力需求结构
结论:大模型发布不再只是推高训练算力峰值,而是直接引爆推理侧的持续消耗。
模型参数规模随着迭代持续放大,每一次发布都需要更高强度的预训练算力。但同时,发布后的推理调用量才是真正的“长期负担”。根据科技日报报道,智算中心传统“裸金属租赁”模式正转向按Token计费/产出衡量,“Token成为AI时代的新数字商品”。这背后,是推理侧消耗的显性化。
经济观察网的报道《谁在消耗5万亿模型算力?》提出,市场需要回答5万亿Token背后的需求来源。这个数字本身虽未得到权威统计,但规模量级已经远超早期模型发布后的水平。我们观察到的规律是:模型发布节点越来越像“算力需求分水岭”,发布前是训练峰值,发布后是推理长尾。
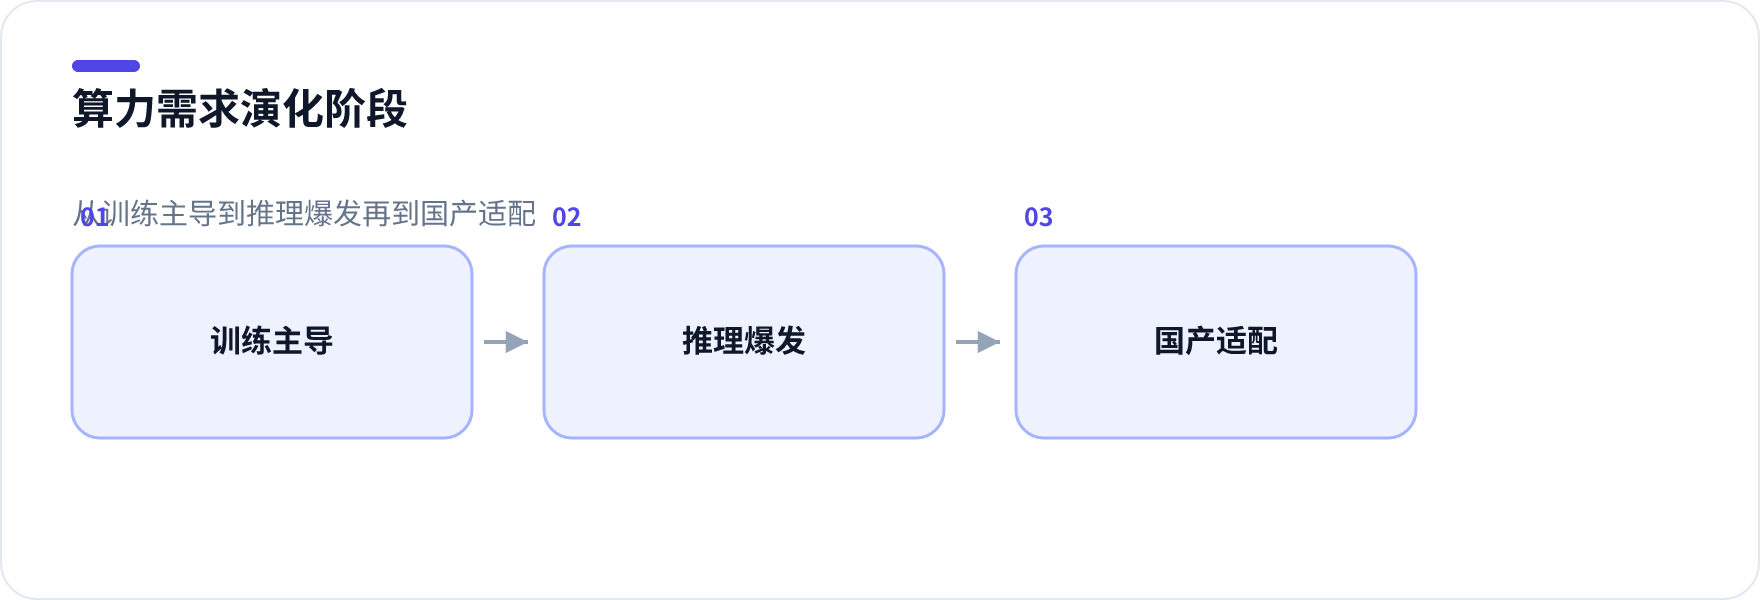
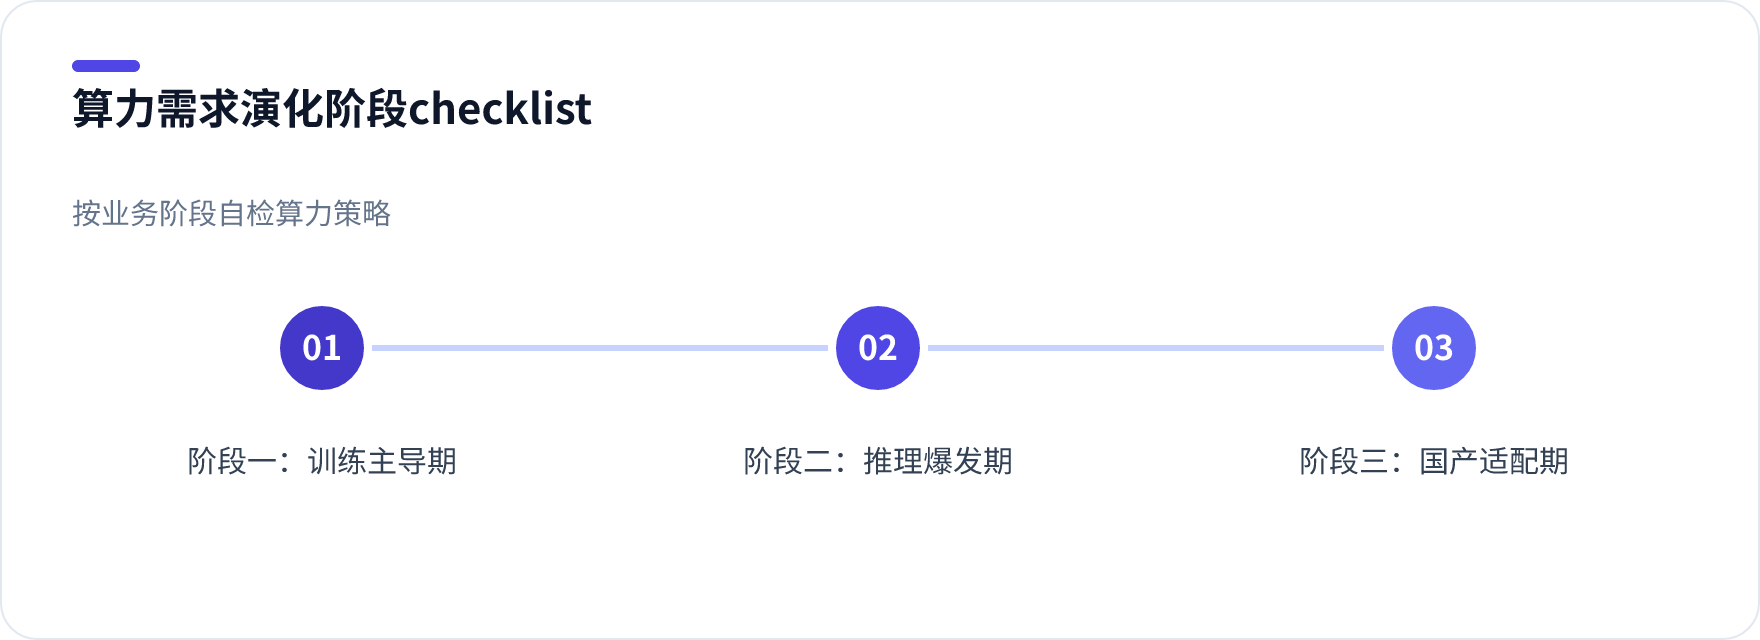
下面这张演化图直观展示需求结构的三次切换。从发展阶段看,算力需求依次经过训练主导、推理爆发、国产适配三个阶段。下表梳理了模型发布节点与算力需求结构变化的关系(基于公开信息整理,非精确数据):
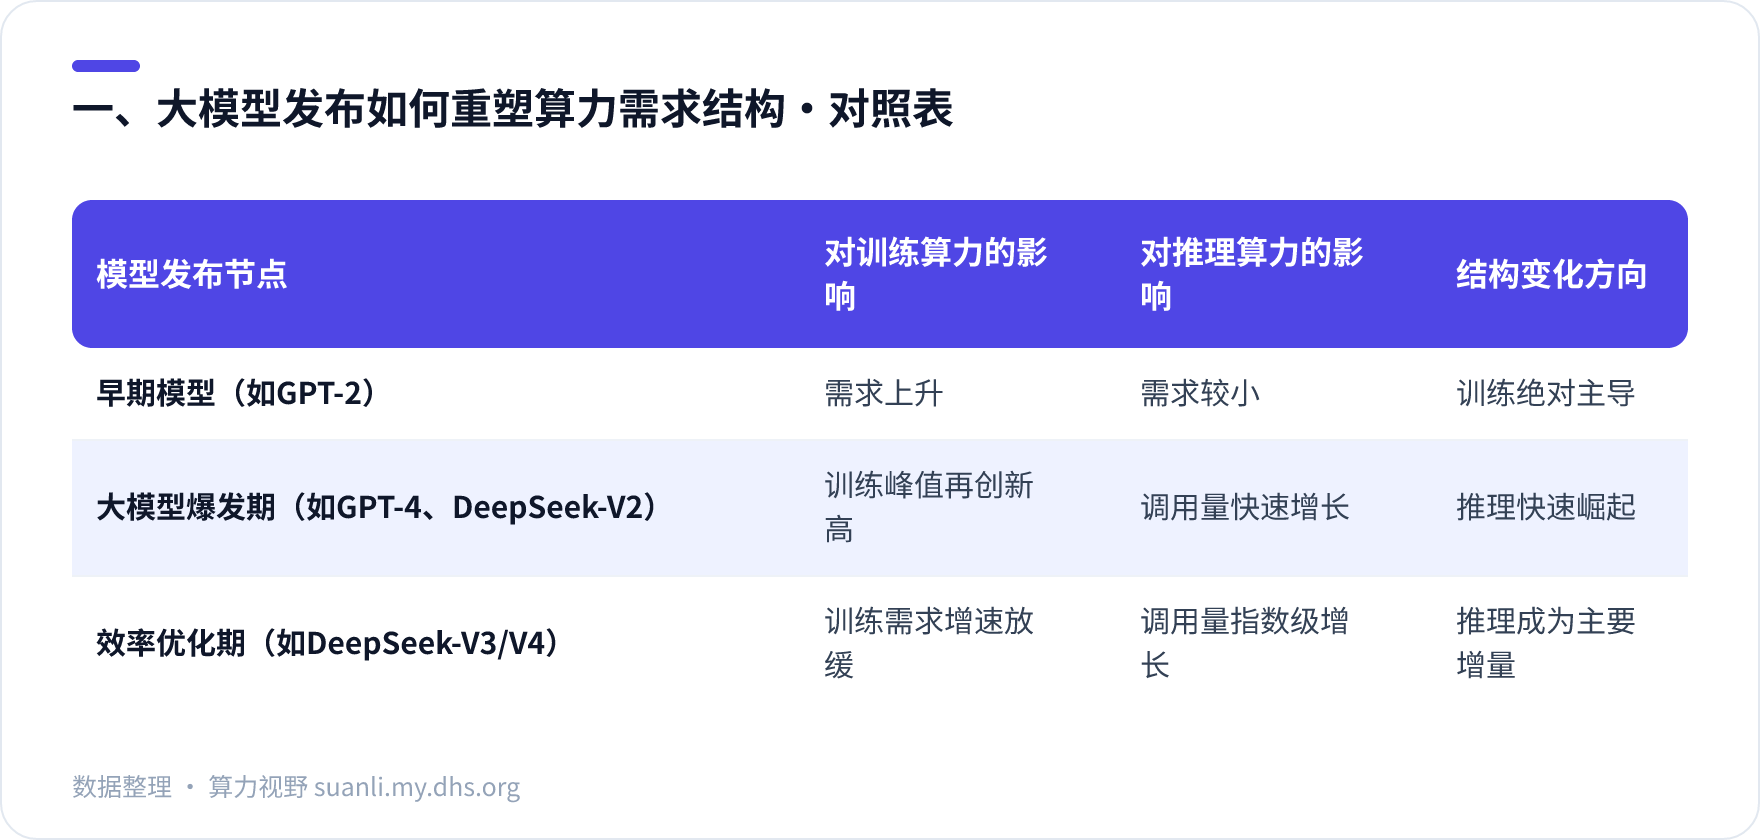
在发布节点前后,训练一侧依然存在,但推理一侧的斜率更陡。用一句话总结:训练算力是“一次性投入”,推理算力才是“持续消耗”。
二、从训练到推理:算力需求中心转移
结论:训练算力是“一次性投入”,推理算力是“持续消耗”,后者正在决定算力需求的边际成本。
训练与推理在消耗模式、成本结构和优化重点上有根本差异。下表直接从商业运营维度做了对照。
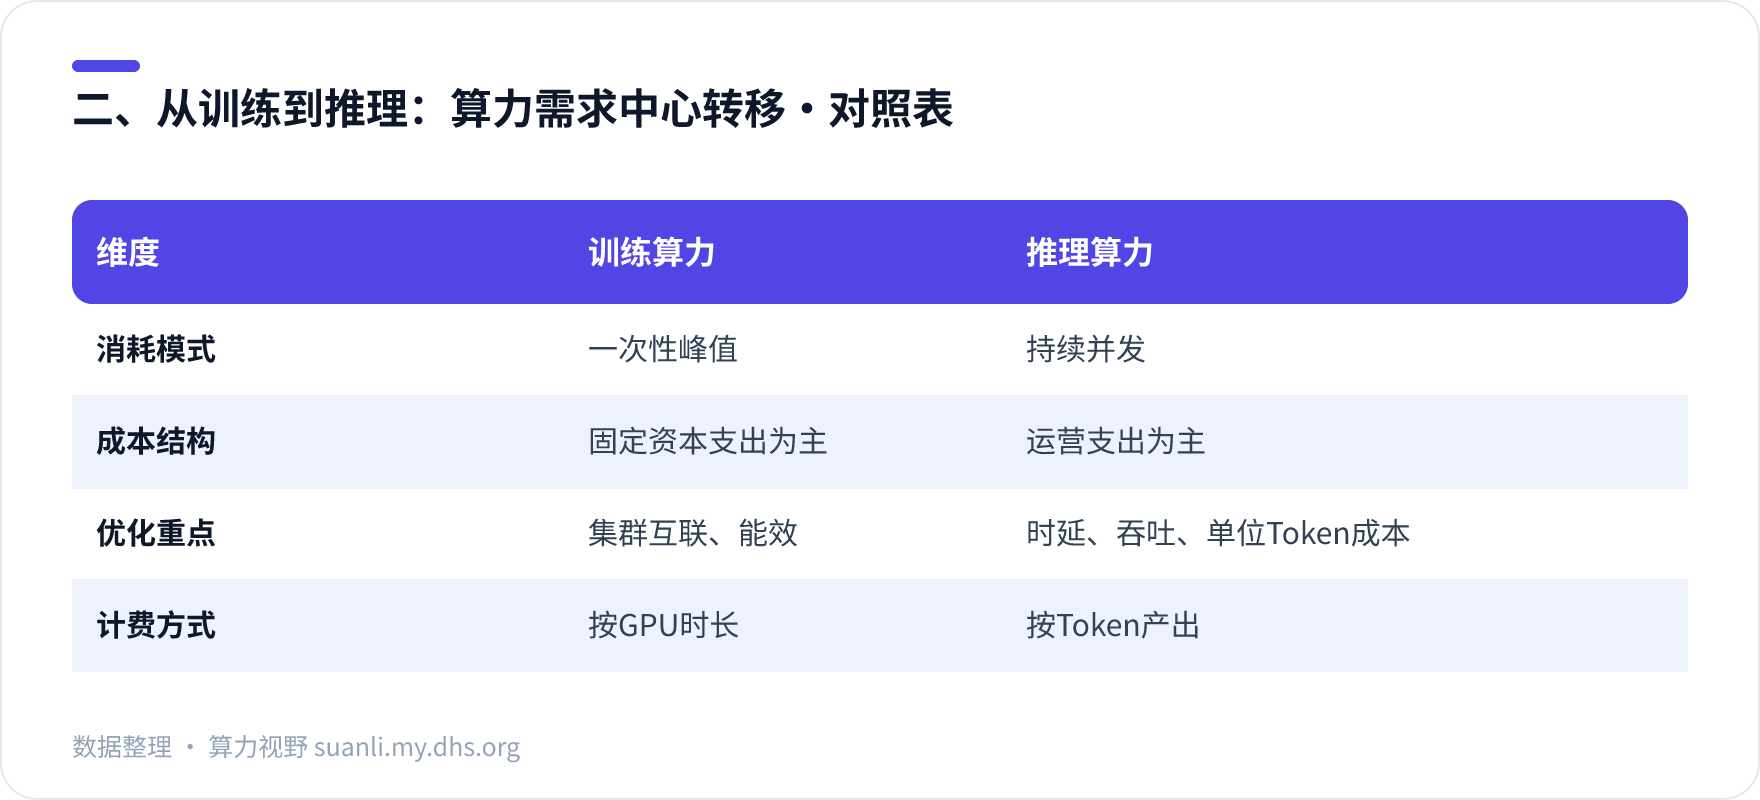
从这张表能看出,训练更接近“项目制”,推理则接近“订阅制”。在推理阶段,单位Token成本成为竞争焦点。AWS官方博客分享的混合部署案例显示,对于延迟敏感型推理,本地IDC优先、云上兜底是常见方案,其Spot实例可节省约67% GPU成本。这恰恰说明推理算力的成本弹性是可以通过架构优化释放的。
随着推理量增长,许多团队开始按Token产出而不是GPU时长来评估成本。这要求算力供应商提供更精细的计量能力。
三、模型效率革命与算力需求的“非线性”增长
结论:模型效率提升不必然减少算力需求,反而因单位成本下降触发使用量爆发,形成效率—需求的循环。
DeepSeek等国产模型通过算法优化大幅降低了单次运行成本,但随后却出现了需求的总量激增——这就是Jevons悖论在AI算力领域的翻版。成本降低让更多应用场景从“不可行”变成“可行”,于是调用量呈数量级上升,总算力消耗不减反增。
清华大学互联网产业研究院曾就“从DeepSeek爆火看算力基建的发展与布局”展开分析,强调微观效率提升与宏观需求扩张并存。新华网也报道“芯模联动降本增效,人工智能景气周期持续扩大”。这说明效率革命不是引擎熄火,而是换挡加速。
对采购决策者来说,不要因为新模型更高效就削减算力预算,反而是要准备应对更大的调用量峰值。如果此前没有按Token计费机制的基建,现在正是升级时点。
四、国产算力生态的适配与机遇
结论:国产算力已从“跟随适配”进入与模型发布同频的“Day 0”阶段,但生态成熟仍需时间。
大模型发布后,华为昇腾、寒武纪等国产芯片厂商通常会尽快跟进适配,部分厂商宣传“Day 0”能力(编辑判断)。表面上,这是国产替代的信号;实际上,真正的挑战在适配深度和持续迭代速度。正如新华网报道的“芯模联动”趋势,模型厂商与芯片厂商的协同正在加快。同时,算力租赁平台也开始设立国产专区,强调信创合规与本地适配。
但我们必须承认,国产芯片在工具链、算子库和框架支持上与英伟达仍有差距,不能宣称“完全替代”。这种差距会在特定场景下影响开发效率。好消息是,国产大模型与国产算力硬件正在同频迭代,形成“国产替代+适配”的双轮驱动。对于有信创合规要求的企业,现在是验证国产算力的窗口期。
五、算力租赁市场的行情变化与选型参考
结论:算力租赁价格与需求联动增强,选型应结合预算与业务弹性,在“租用”和“自购”之间做TCO权衡。
租赁市场出现了明显的分层。以算家云为例,专业版Pro面向长期生产/推理训练,青春版Air面向短期学习/测试验证,并设国产专区。而HOSTKEY提供的GPU服务器支持按小时与按月计费,预配置定制服务器约€118/月起。这种分层意味着,不同业务阶段可以用不同的租赁产品匹配,避免为闲置算力付费。
下面是一张“租用vs自购”的选型对照表,帮你快速决策。
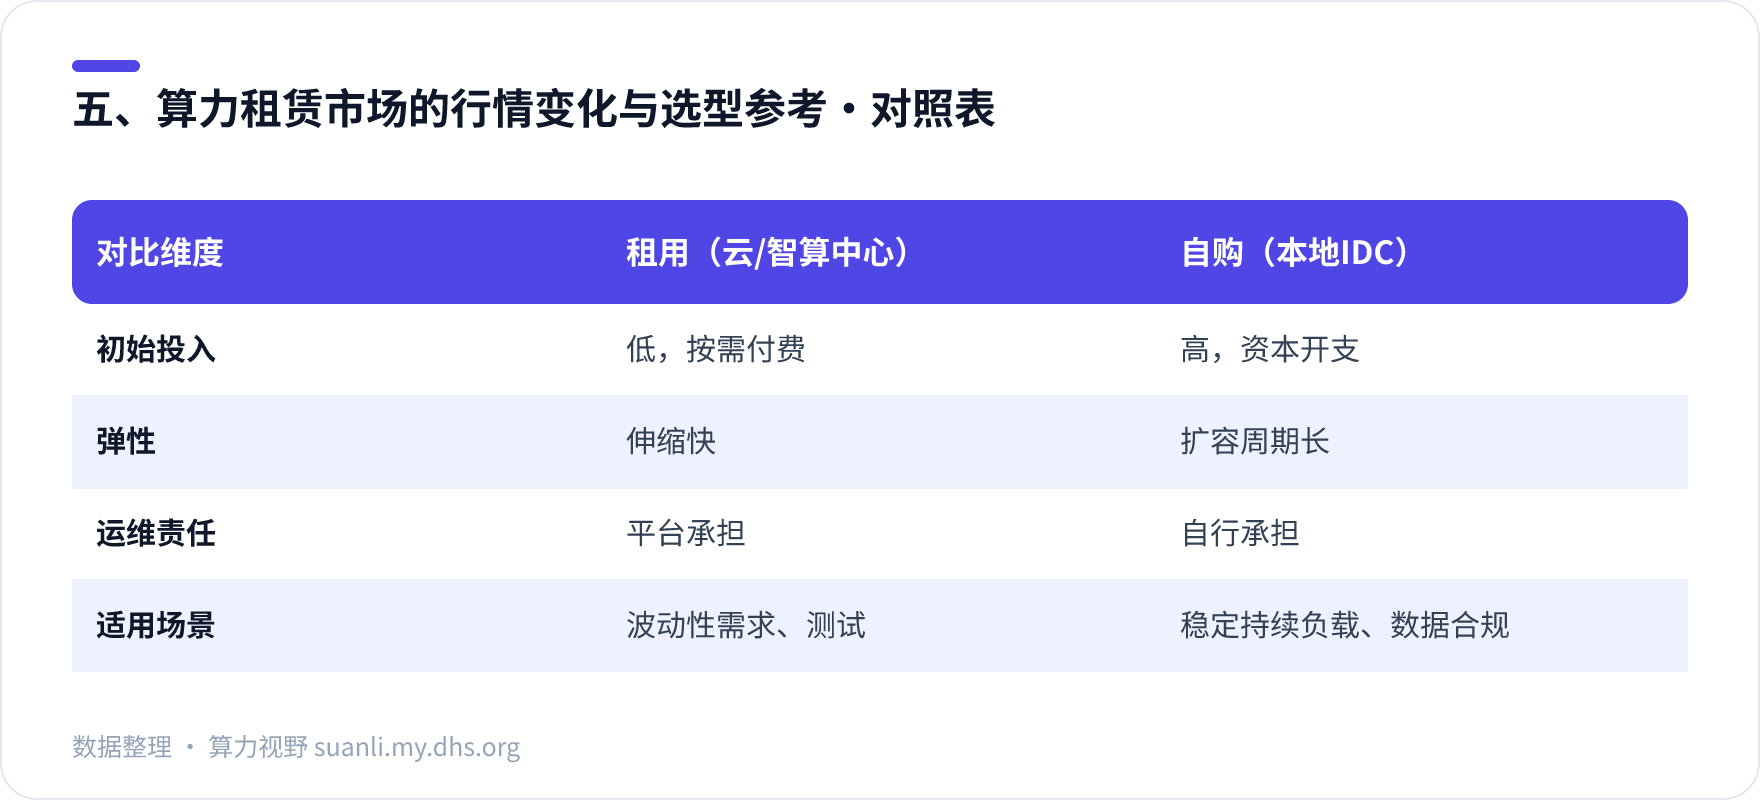
选型逻辑很简单:波动大、预算有限选租赁;稳定负载、数据敏感选自购。但别忽略,租赁价格并非一成不变。市场有消息称,部分GPU租赁价格在短期内出现上涨,但具体涨幅未获官方确认。这意味着对价格敏感的采购方需要关注行情窗口。
为了帮你快速定位当前阶段,我们整理了算力需求演化阶段checklist:
- 阶段一:训练主导期——以模型研发为主,GPU集群扩容优先,关注互联带宽。
- 阶段二:推理爆发期——产品上线,调用量激增,优先评估单位Token成本与弹性伸缩。
- 阶段三:国产适配期——信创与合规驱动,优先验证国产芯片跑通核心模型。
常见问题
大模型发布后算力需求会一直增长吗?
大概率会,但结构会分化。训练侧增速放缓,推理侧持续增长。只要Token消耗量在增加,总需求就不会下降。
如何判断自己需要训练还是推理算力?
如果你在做模型预训练、微调,重点是训练GPU集群;如果只是上线服务供用户调用,就必须算清推理成本(单位Token成本)。可以用上面的对照表辅助判断。
国产芯片跑大模型靠谱吗?
对于常见开源模型,国产芯片已经能跑通,并且有Day 0适配保障。但如果是复杂工具链或特定推理优化,仍需测试验证。不要盲目“完全替代”,应该按场景灰度验证。
算力租赁价格还会涨吗?
没有机构能给出确定的预测。但从Token计费趋势和需求增长看,波动会加大。建议用弹性租赁产品对冲价格风险。
小结与下一步
本文从模型发布节点切入,梳理了算力需求结构变化的三大趋势:训练向推理转移、效率非但不减需求反增、国产算力进入Day 0适配期。同时给出了演化阶段checklist和选型对照表。下一步行动建议:
- 监控单位Token成本:把指标从“GPU数量”改为“每天产出多少Token”。
- 使用弹性租赁:用短租产品验证推理负载,再决定是否长期租赁或自购。
- 预留国产适配预算:在关键任务上给国产芯片一个验证窗口。
- 订阅我们的更新:当重大模型发布或算力价格大幅波动时,可第一时间获取新数据和结论。