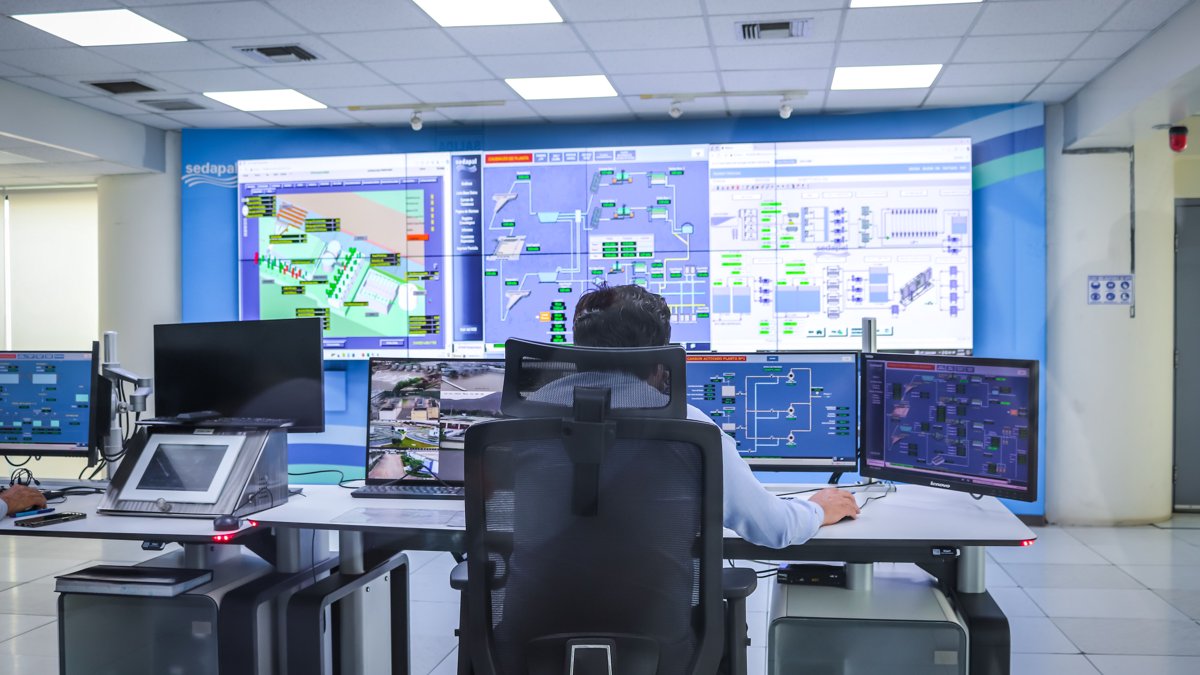
如果你正在为 GPU 集群或智算中心挑选运维工具,面对监控、调度、部署、裸机管理一堆名词很容易挑花眼。这份清单把算力运维工具按四类能力拆开,每类给出典型代表、开源与商业方案对比,并附上原创选型对照表和监控指标参考表,帮你 10 分钟内锁定适合自己集群规模与业务场景的工具组合。
本文要点
- 算力运维工具分为监控告警、调度与资源池、部署自动化、裸机管理四类,选型需按此分类逐一匹配。
- 监控优先考虑 DCGM + Prometheus 组合,但云厂商方案集成度更高;开源灵活但需自建运维。
- 深度学习训练任务适合 Slurm,微服务与推理场景适合 Kubernetes + GPU 插件,混合场景可双栈并行。
- 选型核心指标是算力利用率、故障恢复时间与单位算力成本,而非工具数量。
- 本文附四类工具选型对照表与 GPU 监控指标参考表,可直接用于团队内部选型讨论。
算力运维工具全景:四类工具与典型代表
结论:算力运维工具不是单一产品,而是围绕监控、调度、部署与裸机管理四类能力形成的工具链。 在一个典型的智算中心里,这四类工具各司其职:监控告警负责看住 GPU 利用率与故障,调度与资源池负责把算力分给任务,部署自动化负责把环境一键铺好,裸机管理则处理硬件层面的 IPMI/BMC 与固件。只关注单一类别容易漏掉短板,所以选型要按四类分别评估。
行业趋势也在推动工具升级。科技日报文章指出,智算中心传统“裸金属租赁”模式正转向按 Token 计费/产出衡量,行业竞争核心从 GPU 数量走向 Token 制造效率。这意味着运维的目标不再是“机器不宕机”,而是“单位算力产出更多 Token”,监控与调度的颗粒度都要随之细化。下图展示了四类工具的协同关系。
下面是原创「算力运维工具选型对照表」,覆盖四类工具的代表方案、开源/商业属性、适用场景与核心指标:
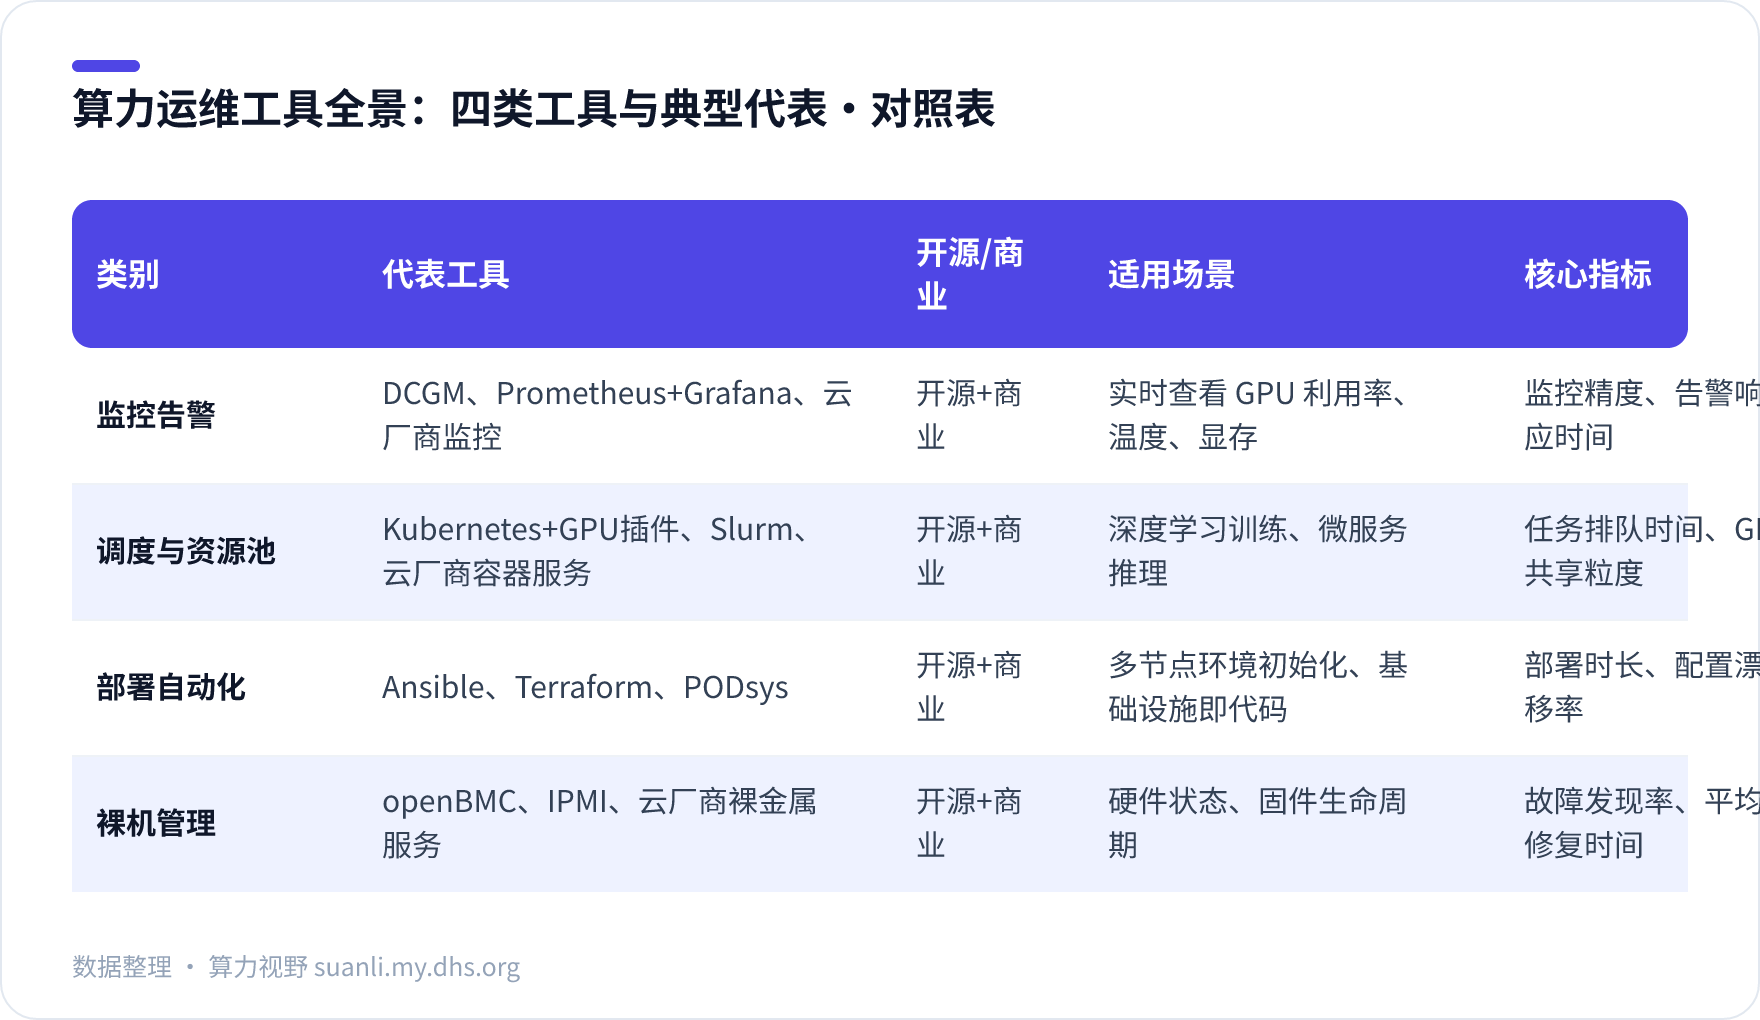
这张表的核心思路是:先确定你的业务是训练还是推理,再决定哪些工具优先配置。例如,以训练为主的团队,调度层的 Slurm 就比 K8s 更契合;而以推理微服务为主,则 K8s + GPU 插件是更好的起点。
监控工具对比:DCGM vs 云厂商方案 vs 开源组合
结论:监控 GPU 利用率的首选是 DCGM 这套英伟达官方工具,但选择云厂商集成方案还是自建开源组合,取决于你对数据完整性和运维成本的取舍。 如果你的集群已经跑在 Kubernetes 上,NVIDIA 官方博客 提供了利用 DCGM 接入 Prometheus、获取跨集群实时 GPU 用量的思路;这种方案指标丰富、粒度细,但需要自己搭建采集与告警链路。而 阿里云容器服务 ACK 的 GPU 监控实践 则展示了托管集群下的开箱即用体验,数据精度与运维负担之间需要权衡。
表格对比三者:
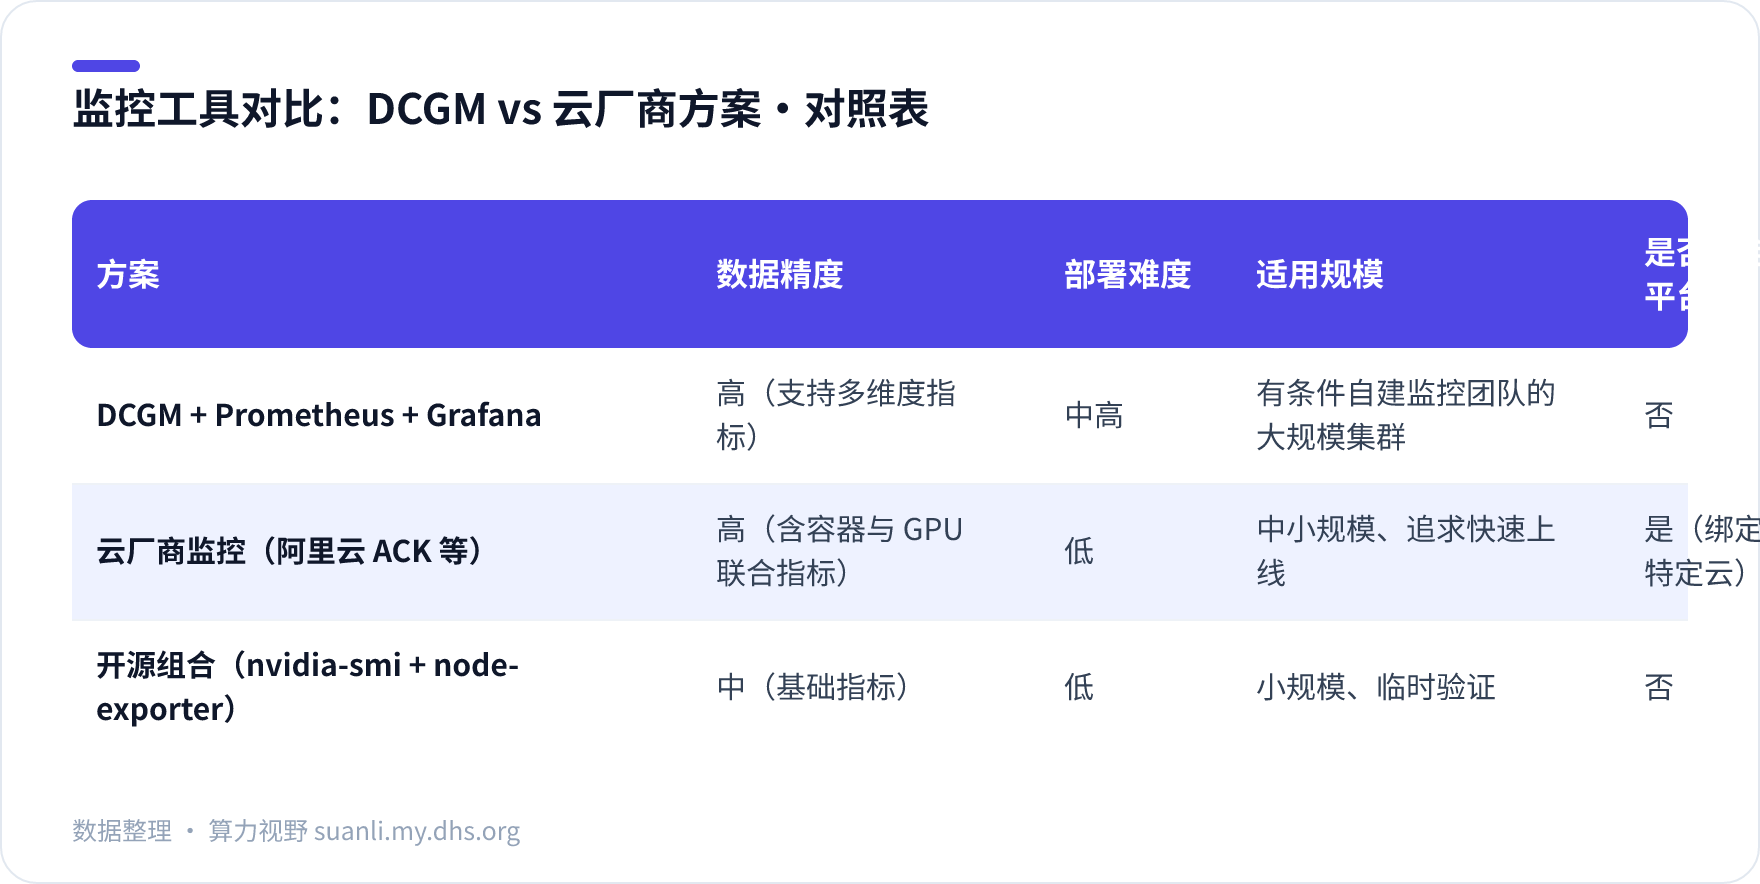
如果你已经有专职运维,DCGM 能给出更细的算力使用率,例如 MIG 实例级别的利用率。若团队只有两三人,云厂商方案能帮你省下大量告警规则配置时间。
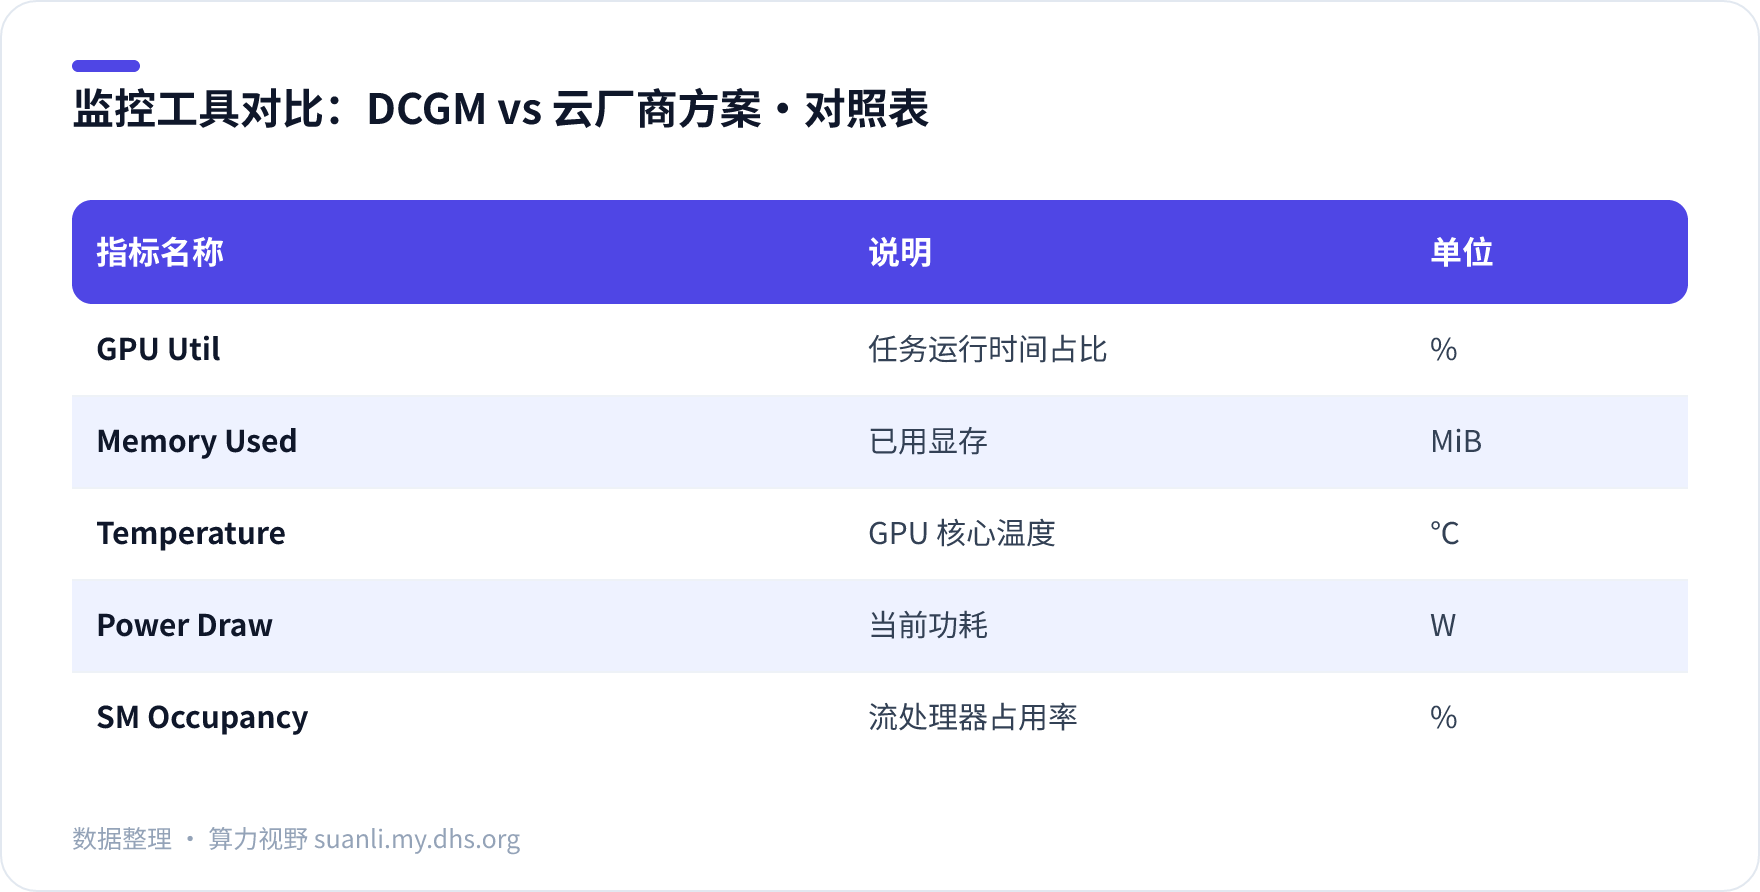
此外,以下是一份可直接用于 Grafana 面板的监控指标参考表,覆盖 GPU 核心、显存、温度与功耗:
调度与资源池工具:K8s+GPU插件 vs Slurm
结论:深度学习训练任务用 Slurm 更合适,微服务推理场景选 Kubernetes + GPU 插件,两种方案也可以在同一集群里共存。 Slurm 是为 HPC 设计的调度器,对并行训练任务的排队、分配、强占支持成熟;而 Kubernetes 的 GPU 插件(如阿里云、京东云提供的)能实现容器级别的算力隔离与弹性。AWS 官方博客演示了本地 IDC K8s 集群 + 云上 EKS 双集群的“本地优先、云上兜底”混合推理架构,这种模式对于数据本地化与合规场景很有参考价值。
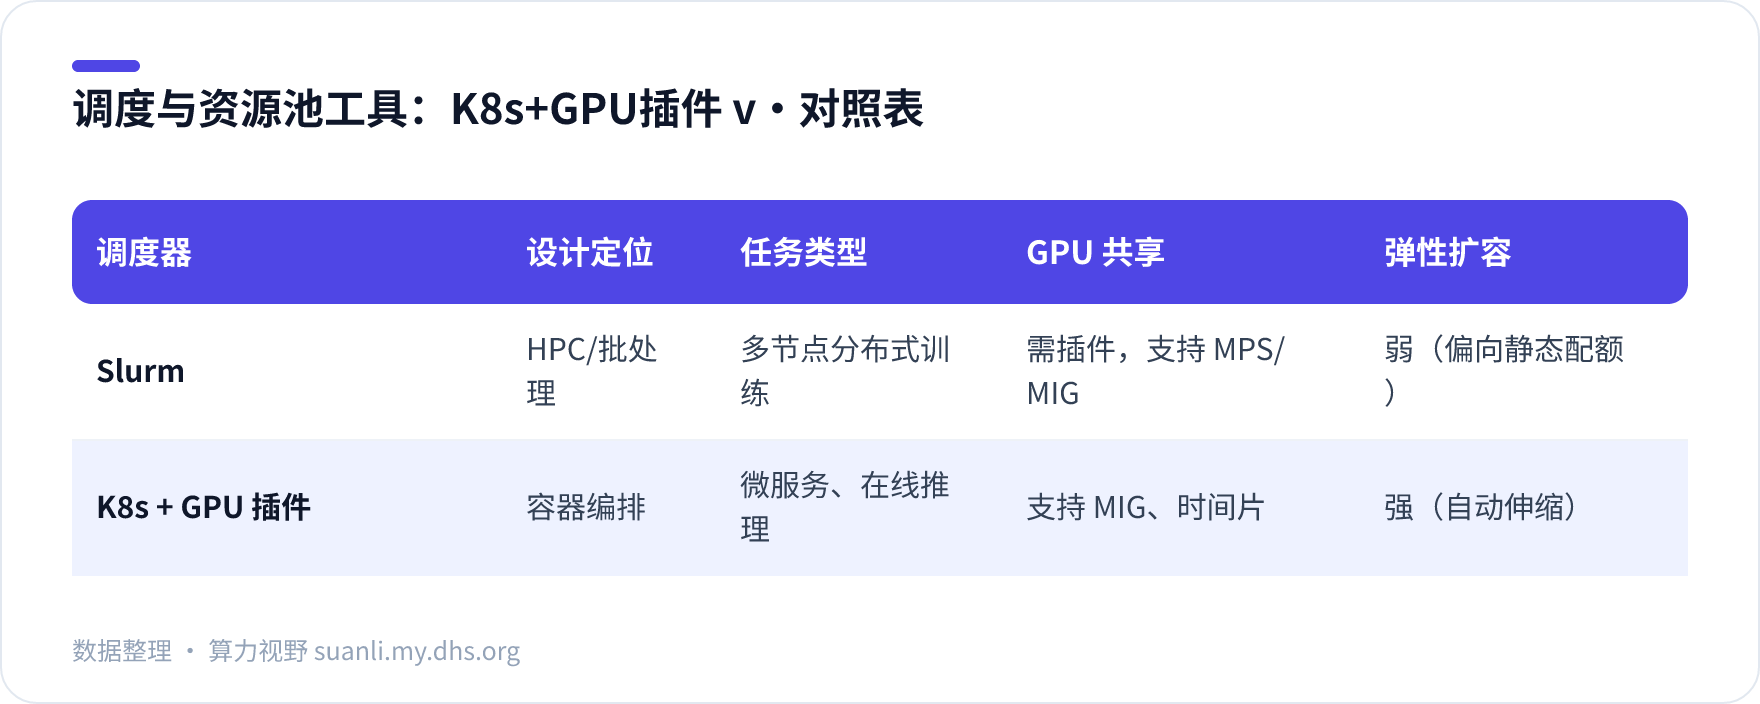
国产算力调度方面,寒武纪等 NPU 厂商通常提供配套的调度组件,但生态成熟度仍在追赶。如果你的业务需要国产化替代,可以优先选择与 NPU 绑定的调度器,再逐步迁移到开源调度体系。
部署与运维自动化:从PODsys到Ansible
结论:算力集群的部署自动化应该遵循“先 IaC 后运维”的原则,Ansible、Terraform 负责基础设施,PODsys 这类行业方案负责大模型场景的全栈部署。 京东云在 自定义 GPU 驱动 的实践中,提供了在容器集群中注入自定义驱动的思路,这对于需要特定 CUDA 版本的团队非常实用。部署自动化不仅能缩短上线时间,还能减少配置漂移导致的故障。
以下是我们总结的部署最佳实践(编辑判断):
- 先做灰度:先部署小部分节点,验证后再全量。
- 可回滚:保留上一版本配置。
- 配置版本化:用 Git 管理基础设施。
常见问题
Q:算力运维工具和普通运维工具的区别?
A:算力运维需要额外关注 GPU 卡级状态、算力利用率、NVIDIA 驱动版本等;普通运维工具只看 CPU/内存/磁盘。比如监控、调度、部署每个层面都要围绕算力做专门适配。
Q:有没有免费的开源算力运维工具?
A:有。Prometheus、Grafana、DCGM、Kubernetes 等都是开源免费,但需要自己部署维护。如果运维人力有限,可以考虑云厂商提供的托管监控。
Q:如何监控 GPU 利用率?
A:用 DCGM + Prometheus + Grafana 可以实时查看。云厂商方案如阿里云 ACK GPU 监控则开箱即用,能结合容器和 GPU 指标统一展示。
Q:国产算力运维工具发展如何?
A:国产 NPU 厂商提供配套监控与调度组件,但生态成熟度仍在追赶。信创场景是主要推力。
Q:小团队怎么选型?
A:优先选云厂商托管方案(如 ACK)+ 开源监控组合,避免自建复杂调度。先保证监控能跑,再逐步优化。
小结与下一步
- 按四类工具盘点现有能力,找出空白。
- 监控先用 DCGM + Grafana 搭一个最小可用面板。
- 调度层根据业务选择 Slurm 或 K8s,不要贪多。
- 部署自动化至少用 Ansible 管理驱动与基础配置。
- 收藏本清单,遇到新工具时回来对照。