拿到GPU服务器后,最常遇到的不是模型跑不起来,而是驱动装不上、容器里看不到GPU、推理时OOM三座大山。这份实操手册把大模型算力部署拆成驱动、容器、推理环境三层,每一步都给出可复制的命令和验证方法,照着做就能把Qwen等开源模型跑通。读完你将获得一份部署Checklist和算力成本对照表,即使从零开始也能一次成功。
本文要点
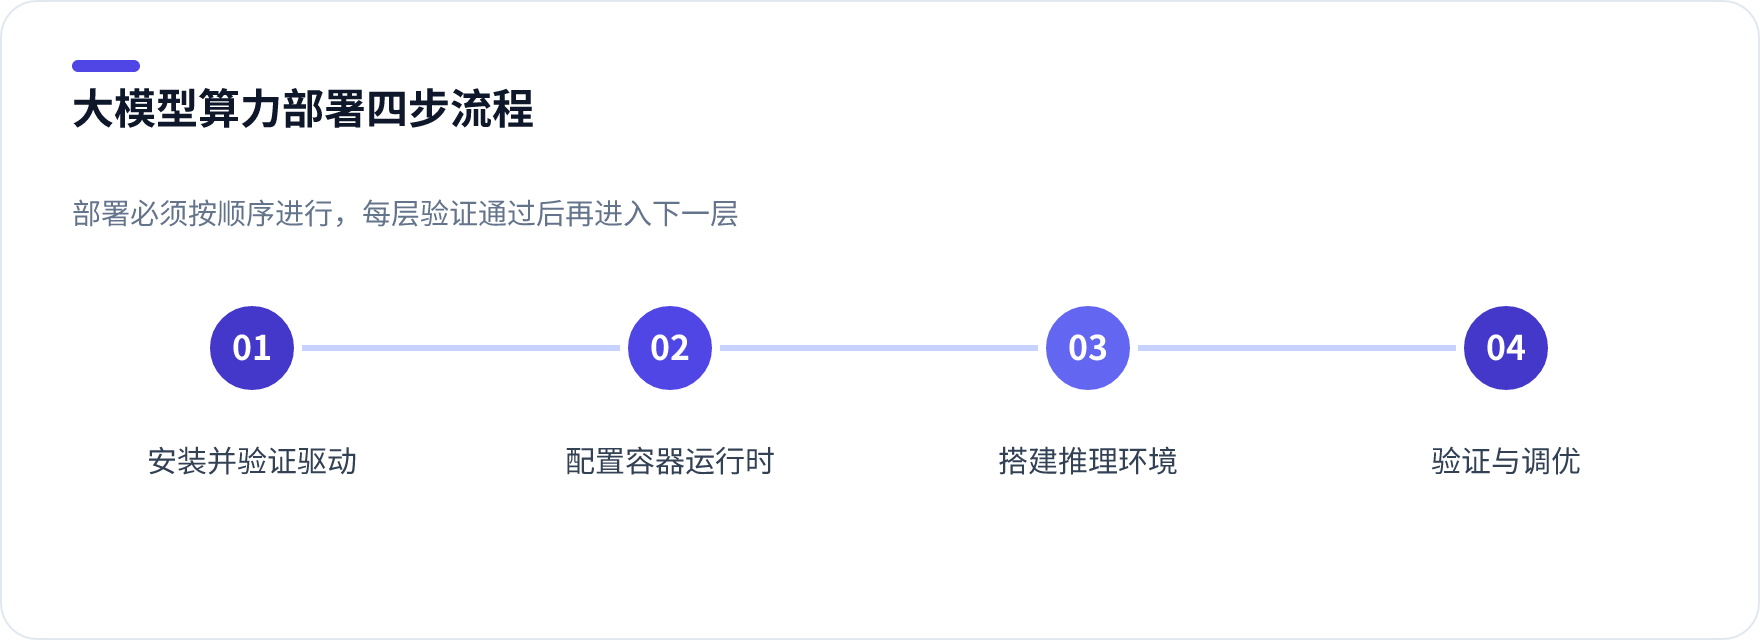
- 部署分三层,顺序不能乱:先装驱动并验证,再配容器运行时,最后搭推理框架,跳过任何一层都会报错。
- 驱动验证只需一条命令:
nvidia-smi能显示GPU型号和显存即算成功。 - 容器内看不到GPU是配置问题:需安装NVIDIA Container Toolkit并设为Docker默认运行时。
- 推理框架选择有黄金法则:高吞吐用vLLM,灵活调试用PyTorch,生产环境推荐vLLM。
- 成本可以从按卡月租开始:用算力租赁平台做早期验证比自购硬件更省钱。
驱动安装:版本选择与验证
结论:驱动版本必须与GPU型号和CUDA版本匹配,安装后先跑 nvidia-smi 验证。
拿到GPU服务器后,第一步是确定型号。在Linux下运行 lspci | grep -i nvidia 可看到GPU型号,然后用 nvidia-smi 看是否已有驱动(没有输出就是没装)。
lspci | grep -i nvidia
nvidia-smi
驱动与CUDA Toolkit的兼容性矩阵非常重要。CUDA Toolkit版本有最低驱动版本要求,装新驱动一般没问题,但反过来装老驱动跑新Toolkit会报错。所以先确定你的训练/推理框架需要什么CUDA版本,再按矩阵选驱动。Ubuntu/Debian环境可以用runfile安装,以NVIDIA-Linux-x86_64-535.104.05.run为例:
chmod +x NVIDIA-Linux-x86_64-535.104.05.run
sudo ./NVIDIA-Linux-x86_64-535.104.05.run
关于驱动与Kubernetes的配合,可以参考京东云关于Kubernetes自定义GPU驱动的官方文档,其中给出了在K8s集群中为GPU节点安装驱动的流程。
安装完成后必须验证:运行 nvidia-smi,能看到GPU型号、显存、驱动版本,才算装好。如果在Ubuntu上遇到黑屏或无法启动,通常是nouveau驱动冲突,禁用nouveau后重启再装。
容器化部署:Docker+NVIDIA Container Toolkit
结论:容器内无法识别GPU,通常不是Docker问题,而是没装NVIDIA Container Toolkit。
Docker本身不知道GPU的存在,需要在宿主机上安装nvidia-container-toolkit,并把它配置为Docker的默认运行时。这是容器化部署最关键的一步。
Ubuntu/Debian安装命令如下:
distribution=$(. /etc/os-release;echo $ID$VERSION_ID)
curl -s -L https://nvidia.github.io/nvidia-docker/gpgkey | sudo apt-key add -
curl -s -L https://nvidia.github.io/nvidia-docker/$distribution/nvidia-docker.list | sudo tee /etc/apt/sources.list.d/nvidia-docker.list
sudo apt-get update && sudo apt-get install -y nvidia-container-toolkit
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
配置完成后,用以下命令测试容器内GPU可见:
docker run --rm --gpus all nvidia/cuda:11.8.0-base-ubuntu22.04 nvidia-smi
能输出GPU信息即配置成功。如果报错"could not select device driver",说明nvidia-container-toolkit未安装或运行时路径未配置。
NVIDIA官方博客在Kubernetes集群GPU实时可见性中给出了跨集群监控GPU利用率的方法,可作为容器化部署后的监控参考。
注意:镜像中的CUDA版本要与宿主机驱动兼容;不要把GPU显存资源全部分给容器,留出系统开销给驱动和监控进程。
推理环境搭建:框架选择与模型加载
结论:推理框架选择取决于模型类型与实时性要求,vLLM适合高吞吐,PyTorch适合灵活调试。
根据模型类型选框架:对Qwen、LLaMA等主流LLM,vLLM提供了高度优化的推理引擎;需要做模型微调或自定义训练的,用PyTorch更灵活。生产环境建议用vLLM以获得更高吞吐。
用conda创建虚拟环境,按CUDA版本安装PyTorch(cuda 11.8对应torch 2.x):
conda create -n llm python=3.10 -y
conda activate llm
pip install torch==2.0.1+cu118 torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
pip install vllm
以Qwen-7B为例,用PyTorch加载模型:
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen-7B").to("cuda")
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen-7B")
若仅需快速验证,可直接用vLLM启动OpenAI兼容API:
python -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen-7B \
  --gpu-memory-utilization 0.8 \
  --max-model-len 4096
在实际部署中需根据显存调整加载方式。设置关键环境变量:CUDA_VISIBLE_DEVICES指定GPU,max_seq_len控制上下文长度。
三层部署的兼容性对照如下表:
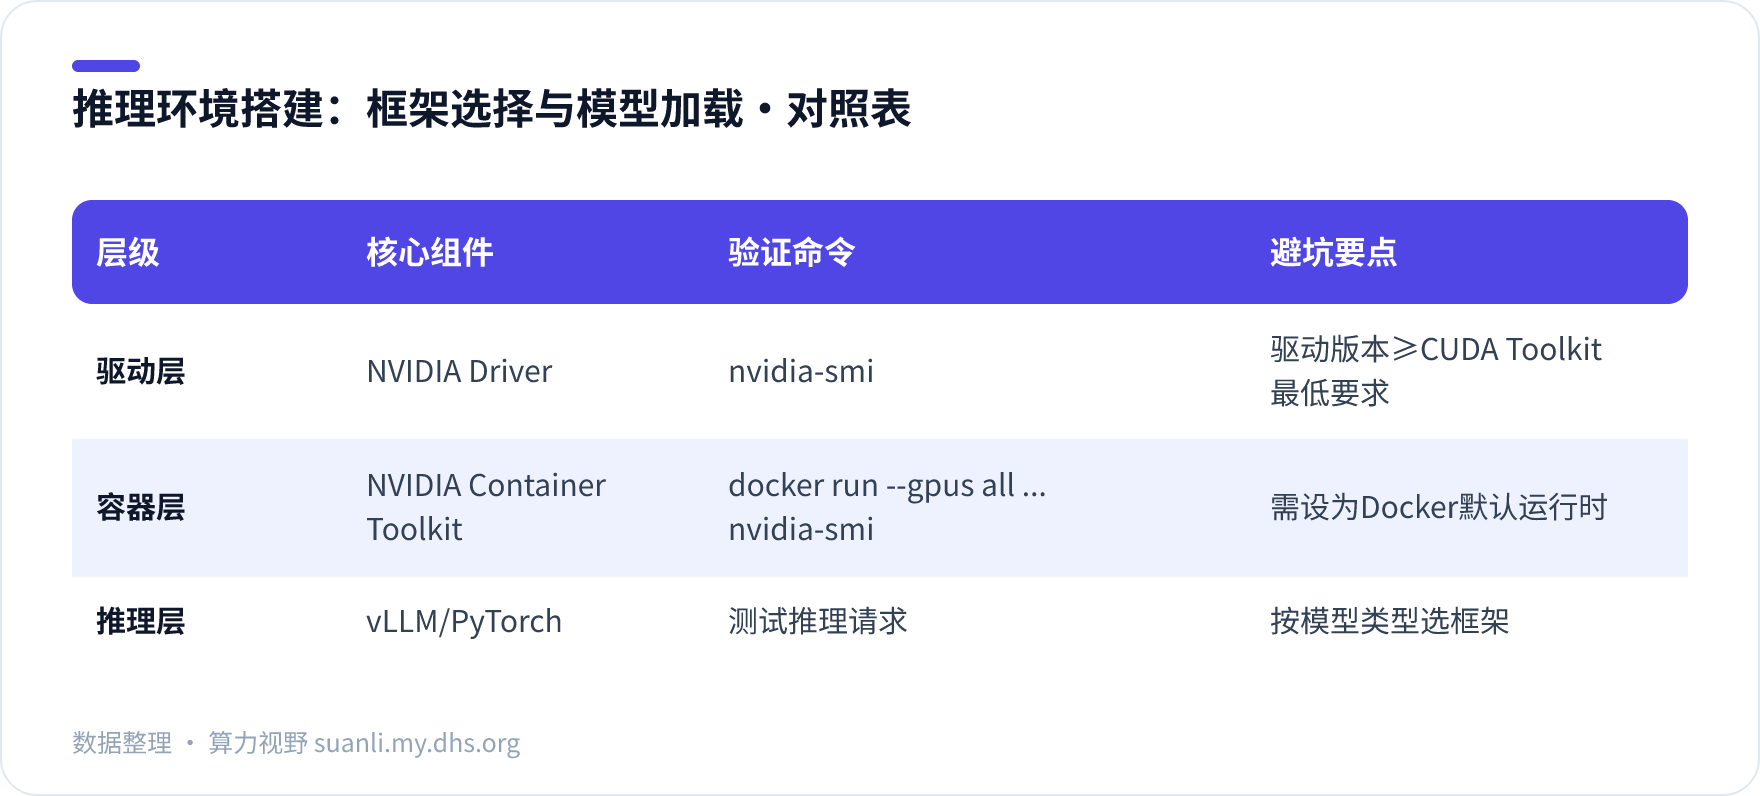
对照此表逐层排查,能快速定位是驱动、容器还是框架层的问题。
验证输出正确:输入一个prompt,检查生成token数、内容合理性,确认日志中无CUDA错误。如果OOM,降低batch_size或换更小的模型。
部署验证与性能调优
结论:验证部署成功不是看服务启动,而是用nvidia-smi+benchmark双重确认。
启动推理服务后,在终端运行 watch -n 1 nvidia-smi 看GPU利用率和显存占用;如果模型卡在加载阶段,显存会持续走低或为0,说明环境有问题。
用容器日志检查请求是否成功:在Docker logs中看到HTTP 200或自定义服务日志中的success即算通过。
阿里云在GPU资源监控最佳实践中提供了Prometheus采集GPU指标的方案,适合生产环境的持续监控。
若性能不达标:调整tensor_parallel_size(模型并行度)、max_num_seqs(批量并发)、gpu_memory_utilization(显存利用率)。用vLLM的benchmark_serving命令测试吞吐(tokens/s)。
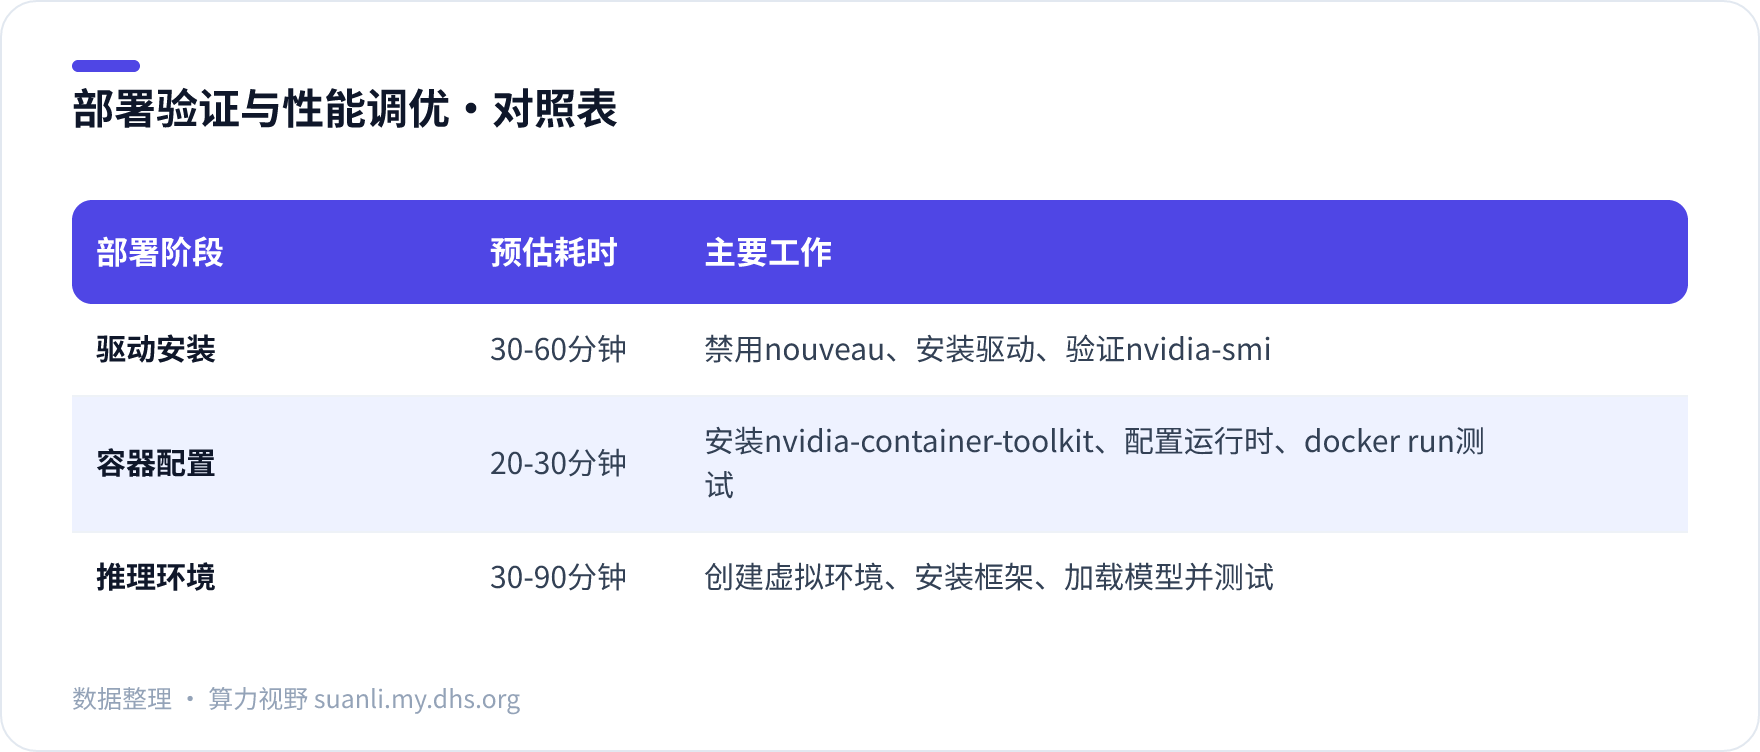
以单卡推理为例,新手从零到跑通模型的大致耗时如下(编辑预估,实际因硬件与网络而异):
常见问题FAQ
Q1:大模型算力部署需要哪些步骤?
分三步。第一,安装NVIDIA驱动并验证(nvidia-smi);第二,配置Docker+NVIDIA Container Toolkit,用docker run测试GPU可见;第三,搭建推理框架(如vLLM),加载模型并验证输出。顺序不能乱,否则会浪费大量时间排查。
Q2:如何安装NVIDIA驱动?
先查GPU型号和需要的CUDA版本,到NVIDIA官网下载对应驱动(或系统包管理器安装),安装后运行nvidia-smi确认。若黑屏,先禁用nouveau。
Q3:Docker部署大模型需要注意什么?
必须安装nvidia-container-toolkit并设置为Docker默认运行时;镜像中的CUDA版本要与宿主机驱动兼容;容器不要占满显存,预留系统开销;用docker logs查看推理日志比进容器调试更高效。
Q4:大模型推理环境怎么配置?
用conda创建虚拟环境,按CUDA版本安装PyTorch;模型加载用transformers的AutoModelForCausalLM;关键参数CUDA_VISIBLE_DEVICES指定GPU,max_seq_len控制上下文长度。生产环境建议用vLLM以获得更高吞吐。
Q5:私有化部署大模型成本多少?
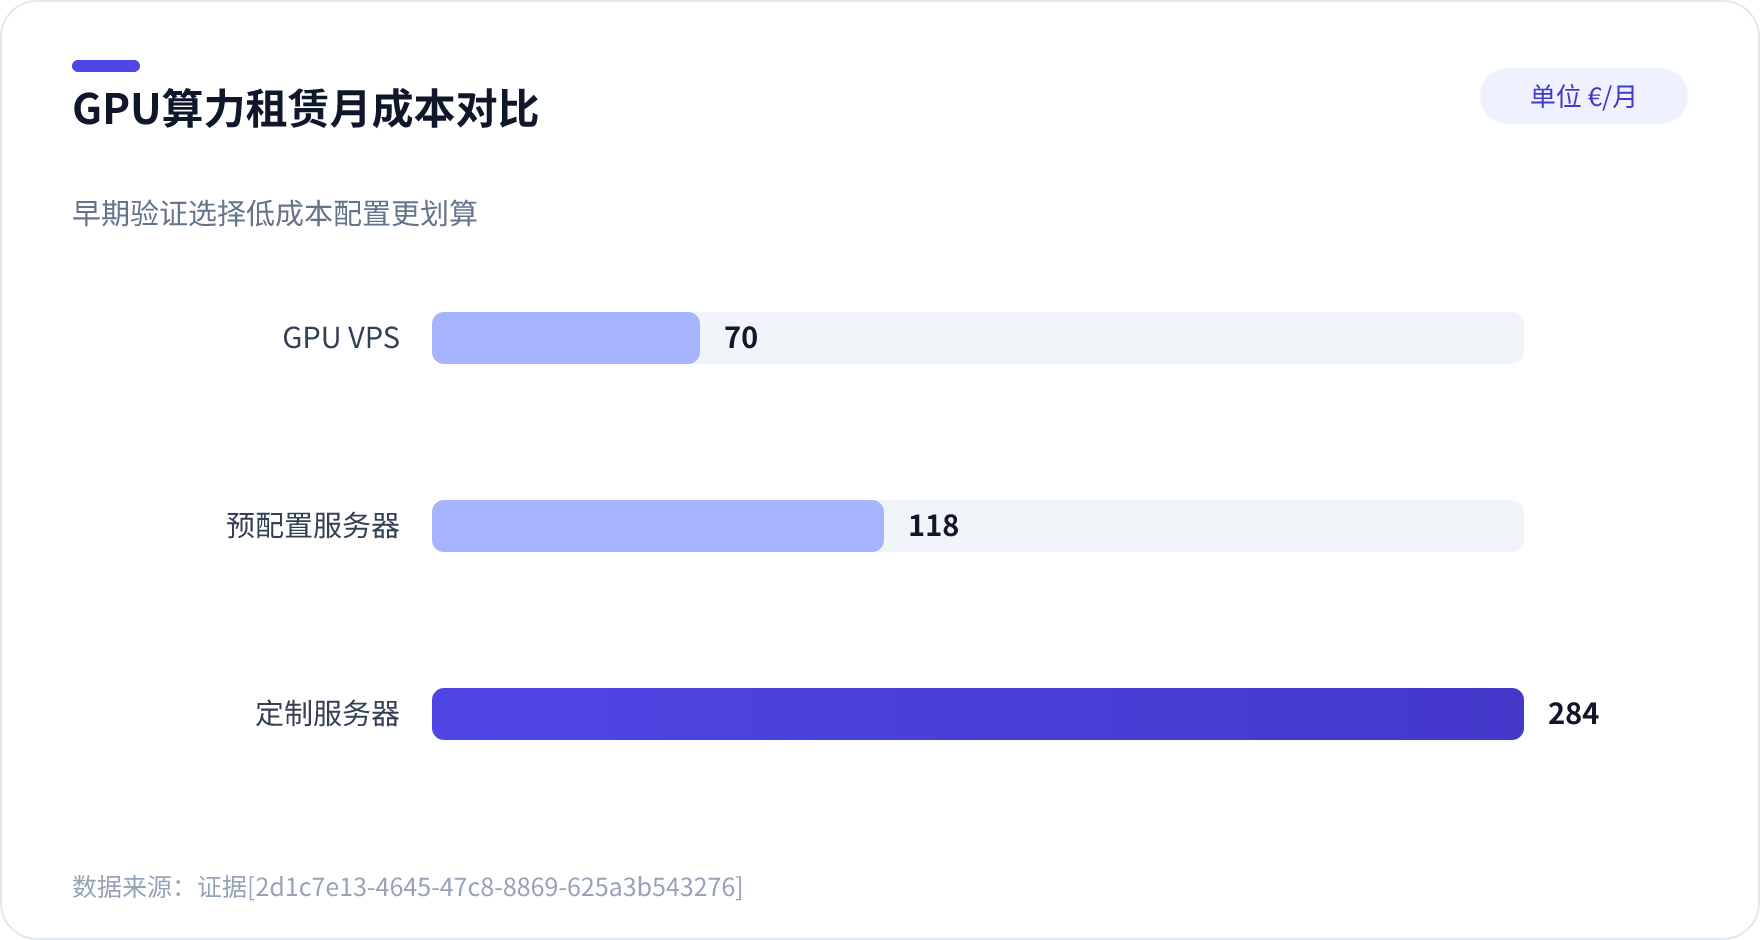
取决于硬件和模型规模。早期验证可从算力租赁开始,以欧洲某GPU托管服务商公开报价为例:
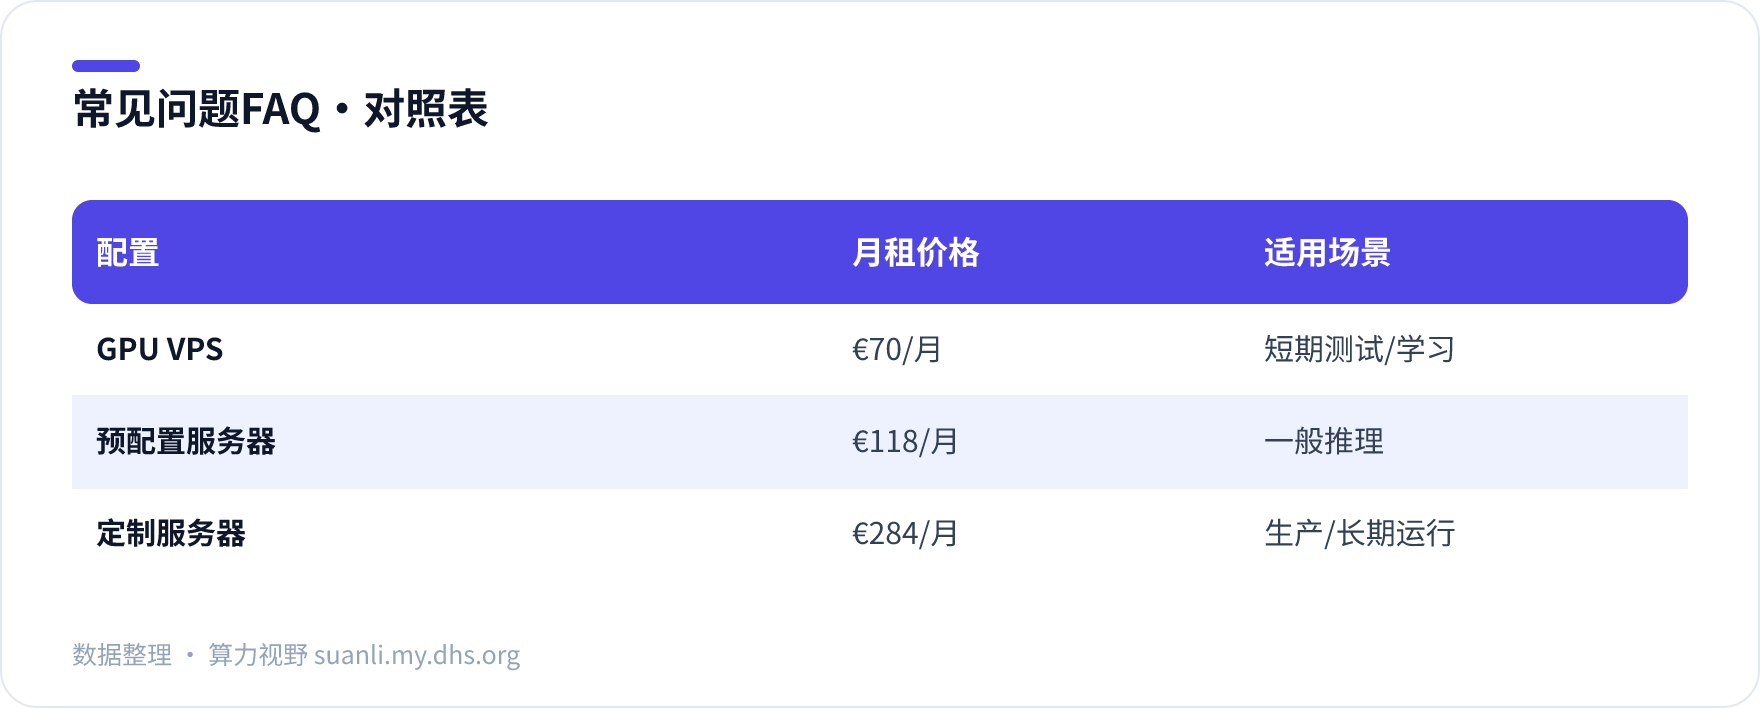
以上为某欧洲GPU托管服务商公开报价,长期运行可参考使用Spot实例节省约67%成本的方案。
小结与下一步
- 驱动安装后运行nvidia-smi确认GPU识别
- 配置nvidia-container-toolkit后用docker run测试容器内GPU
- 虚拟环境中安装匹配CUDA的PyTorch
- 模型加载后发送测试请求验证输出
- 性能不达标时调tensor_parallel_size等参数
在延迟敏感业务中(本地TTFT约70ms),本地优先部署仍具有价值,云上兜底扩容可作补充。混合部署的动因还包括数据本地化/合规、成本考量与已有GPU投资利旧。
下一步建议:保存环境快照(docker commit或虚拟机快照),方便回滚;尝试多卡并行(tensor_parallel_size=2)看吞吐提升;关注官方更新(如vLLM新版本),按需切换推理引擎。
按此流程部署一次可复现,建议保存环境快照。如需进一步优化,订阅获取更新。